
 Максим Дорохов
Нагрузочное тестирование сайта: ab, wrk, k6 и JMeter — как не положить прод и что измерять
Перед акцией или релизом хочется знать, сколько запросов в секунду выдержит сайт, прежде чем начнёт отдавать 502 и таймауты. Разбираем виды тестов, почему среднее время ответа врёт, как не попасть под собственный антиддос, чем отличаются ab, wrk, k6, JMeter, Locust и Яндекс.Танк, как читать их вывод и что чинить. Флаги сверены с документацией на сентябрь 2026 года, вывод ab, wrk и k6 получен реальными прогонами.
Нагрузочное тестирование сайта — контролируемая подача на сервер заданного числа запросов в секунду или одновременных пользователей с измерением времени ответа, доли ошибок и потребления ресурсов, чтобы найти предел, после которого сайт деградирует. Результат теста — не одно число «RPS», а кривая: как растут p95-латентность и ошибки с ростом нагрузки и где они срываются. Тест, который меряет только среднее время ответа, предел не покажет.
Чем нагрузочный тест отличается от стресс-, soak- и spike-теста
Разница — в профиле нагрузки и вопросе, на который отвечает тест: нагрузочный (average-load) проверяет ожидаемый трафик, стресс — трафик выше ожидаемого, soak — долгую работу, spike — резкий всплеск, breakpoint — плавный рост до отказа. Классификация — по руководству k6 «Load test types».
| Вид теста | Нагрузка | Длительность | Вопрос |
|---|---|---|---|
| Нагрузочный (average-load) | Обычный пик продакшена | 5–60 минут | Держит ли сайт типичный трафик с приемлемой латентностью |
| Стресс | Выше обычной: +50–100 % и больше | 5–60 минут | Насколько деградирует сайт и выживает ли |
| Soak (выносливость) | Обычная | Часы: 3, 8, 12, 24, до 72 | Есть ли утечки памяти, рост очередей, переполнение дисков |
| Spike (всплеск) | Очень высокая, без полки | Минуты | Переживёт ли сайт наплыв после рассылки и восстановится ли |
| Breakpoint | Плавный рост до отказа | Сколько потребуется | Где предел и что ломается первым |
Для первого теста перед акцией достаточно двух: average-load на ожидаемом пике и стресс на удвоенном; soak и spike — следующий шаг.
Какие метрики измерять и почему среднее время ответа врёт
Минимум — четыре метрики одновременно: RPS, латентность по перцентилям (p50, p95, p99), доля ошибок и насыщение ресурсов сервера. Среднее не подходит потому, что распределение времени ответа под нагрузкой несимметрично: тысячи быстрых ответов и десятки зависших дают «приличное» среднее, за которым прячется каждый сотый пользователь с секундным ожиданием.
Пример из прогона wrk ниже: среднее — 29,76 мс, медиана — 3,97 мс, p99 — 943 мс. Среднее в 7,5 раза больше медианы и в 32 раза меньше p99 — не описывает ни типичный, ни худший случай. Поэтому в k6 пороги задают на p(95), а JMeter выводит 90-й, 95-й и 99-й перцентили.
| Метрика | Где смотреть | Признак предела |
|---|---|---|
| RPS | Requests per second в ab, Requests/sec в wrk, http_reqs в k6 | Перестаёт расти при росте нагрузки, затем падает |
| p50 / p95 / p99 | Percentage served в ab, --latency в wrk, p(95) в k6 | p95 растёт быстрее p50 — образуется очередь |
| Доля ошибок | Failed / Non-2xx в ab, Socket errors в wrk, http_req_failed в k6 | Устойчивый рост выше 0,1–1 % |
| CPU, память, load average | top, vmstat, free -m, journalctl -k | CPU около 100 %, LA выше числа ядер, swap, «Killed process» |
| Соединения и воркеры | ss -s, ss -ltn, страница статуса PHP-FPM | listen queue больше 0, max children reached |
Метрики генератора и сервера снимают одновременно, иначе непонятно, почему вырос p95. Чем занят сервер до первого байта, разобрано в статье про TTFB и способы его снизить.
Как не положить продакшен и не попасть под антиддос
Нагрузочный тест с точки зрения сети неотличим от DDoS-атаки, поэтому первое правило — предупредить всех между вами и сервером: хостинг, CDN, сервис защиты. Второе — тестировать в согласованное окно, начиная с нагрузки, которую сайт заведомо держит, и наращивая её ступенями.
Cloudflare, DDoS-Guard, Qrator и подобные сервисы считают тысячи однотипных запросов с одного IP атакой: включат капчу или JS-challenge, отбросят соединения — и вы получите цифры защиты, а не сайта. Справочник Cloudflare по симуляции DDoS-атак не требует согласования для собственных зон, но автоматическую митигацию это не отменяет. Практика: бить в origin по IP с заголовком Host, а адрес генератора внести в исключения у защиты и хостера.
Тестировать — с отдельной машины, иначе генератор конкурирует с сайтом за CPU, и с каналом шире трафика: 1 000 RPS по 200 КБ — уже 1,6 Гбит/с. Письма, платежи и запись заказов отключить. Останавливаться, как только ошибки превысили 1 % или p95 ушёл за порог.
Какой инструмент выбрать: ab, wrk, k6, JMeter, Locust или Яндекс.Танк
Для одной страницы хватает ab или wrk; для сценария «зашёл, поискал, положил в корзину» с порогами — k6, JMeter или Locust; для RPS-профилей с автостопом — Яндекс.Танк. Сравнение по документации на сентябрь 2026 года:
| Инструмент | Сценарии | Протокол | Распределённость | Отчёты | Порог входа |
|---|---|---|---|---|---|
| ab (ApacheBench 2.3) | Нет: один URL, флаги | HTTP/1.0, keep-alive только с -k | Нет, один процесс | Текст с перцентилями | Минуты |
| wrk 4.x / wrk2 | Lua-скрипты (-s) | HTTP/1.1, keep-alive по умолчанию | Нет; многопоточный (-t) | Текст, --latency; в wrk2 HdrHistogram и -R | Минуты |
| k6 2.3 (Grafana) | JavaScript: stages, checks, thresholds | HTTP/1.1, автоматически HTTP/2, WebSocket, gRPC | Grafana Cloud k6, k6-operator | Консоль, --out json/csv/influxdb | Час: бинарник и базовый JS |
| JMeter 5.6.3 | GUI-конструктор, JMX, любые протоколы | HTTP/1.1; HTTP/2 через плагин | Да: -r / -R, remote_hosts | HTML-дашборд (-e -o) с APDEX | День: Java 8+, тяжёлый GUI |
| Locust 2.46 | Python-классы пользователей | HTTP/1.1; другие протоколы своим клиентом | Да: --master / --worker, воркер на ядро | Веб-интерфейс на :8089, CSV | Час, если знаете Python |
| Яндекс.Танк | YAML и патроны; Phantom, Pandora, JMeter, BFG | HTTP/1.x в Phantom; HTTP/2 в Pandora | Нет встроенной | Консоль, автостоп, выгрузка в Overload | Часы: Linux, свои форматы |
Главная ловушка ab — протокол. По документации Apache, ab «не реализует HTTP/1.x полностью», в логе сервера его запросы видны как «GET / HTTP/1.0»: без -k каждый запрос открывает новое TCP-соединение, и вы измеряете рукопожатия, а не приложение. Браузеры ходят по HTTP/1.1 и HTTP/2 с keep-alive, поэтому цифры ab без -k хуже реальности.
Как запустить ab и прочитать его вывод
Два обязательных флага — -n (запросов всего) и -c (одновременно); без них ab делает один запрос, который документация называет нерепрезентативным. Ниже — реальный прогон против локального python -m http.server.
ab -n 2000 -c 50 http://127.0.0.1:8080/
# -k keep-alive, -t 30 лимит секунд, -l терпеть разную длину,
# -H "Host: example.com" при тесте origin по IP

Concurrency Level:      50
Time taken for tests:   1.488 seconds
Complete requests:      2000
Failed requests:        0
Requests per second:    1344.10 [#/sec] (mean)
Time per request:       37.200 [ms] (mean)
Time per request:       0.744 [ms] (mean, across all concurrent requests)

Connection Times (ms)
              min  mean[+/-sd] median   max
Connect:        0    2  39.2      0    1017
Processing:     0    4   2.0      4      25
Waiting:        0    4   1.8      3      24
Total:          1    6  39.4      4    1027

Percentage of the requests served within a certain time (ms)
  50%      4
  90%      6
  95%      8
  99%     12
 100%   1027 (longest request)
Читать нужно три места. «Time per request (mean)» 37,2 мс — столько ждал один виртуальный пользователь; строка «across all concurrent requests» — просто 1/RPS, её путают с латентностью. Перцентили: 99 % ответов уложились в 12 мс, один ждал 1 027 мс. Connect с max 1 017 мс: ровно секунда — начальный таймаут повтора SYN по RFC 6298, сервер не успел принять соединение. Уже на 50 соединениях без keep-alive виден первый предел — очередь accept.
Как запустить wrk и что означают его строки
wrk задаёт нагрузку временем: -t потоков, -c соединений всего, -d длительность, --latency включает перцентили. Он держит соединения открытыми и выдаёт сотни тысяч запросов в секунду с одной машины — начинайте с -c 10.
wrk -t2 -c50 -d10s --latency http://127.0.0.1:8080/

Running 10s test @ http://127.0.0.1:8080/
  2 threads and 50 connections
  Thread Stats   Avg      Stdev     Max   +/- Stdev
    Latency    29.76ms  152.86ms   1.67s    96.64%
    Req/Sec     0.87k   454.01     1.71k    59.43%
  Latency Distribution
     50%    3.97ms
     90%    6.06ms
     99%  943.00ms
  15250 requests in 10.01s, 3.39MB read
  Socket errors: connect 0, read 0, write 0, timeout 5
Requests/sec:   1522.74
Transfer/sec:    346.52KB
Stdev 152 мс в пять раз больше среднего: почти все ответы лежат около медианы, а редкие выбросы тянут хвост до 1,67 с. Пять таймаутов в Socket errors — ответы дольше 2 с (таймаут по умолчанию). Req/Sec в Thread Stats — на поток, Requests/sec внизу — суммарный.
Слабость wrk — coordinated omission: следующий запрос уходит только после ответа на предыдущий, в момент зависания сервера wrk перестаёт мерить, и p99 выходит оптимистичнее реальности. Форк wrk2 добавляет -R для постоянного RPS и считает задержку от момента, когда запрос должен был уйти по расписанию: wrk -t2 -c100 -d30s -R2000 — тест «2 000 запросов в секунду», а не «100 соединений».
Как написать сценарий k6 с порогами
k6 описывает тест JavaScript-файлом: stages задаёт профиль виртуальных пользователей, thresholds — критерии успеха, check — проверки ответа. Если порог не выполнен, k6 выходит с кодом 99 — тест в CI падает сам.
// load.js — average-load с заходом в стресс
import http from 'k6/http';
import { check, sleep } from 'k6';

export const options = {
  stages: [
    { duration: '30s', target: 20 },  // разгон до 20 VU
    { duration: '1m',  target: 20 },  // полка: обычный пик
    { duration: '30s', target: 60 },  // втрое выше обычного
    { duration: '20s', target: 0 },   // спад
  ],
  thresholds: {
    http_req_duration: ['p(95)<500', 'p(99)<1000'],
    http_req_failed:   ['rate<0.01'],
  },
};

export default function () {
  const res = http.get('https://example.com/catalog/');
  check(res, { 'status is 200': (r) => r.status === 200 });
  sleep(1);
}
k6 run load.js
# пример вывода (сокращён)
  █ THRESHOLDS
    http_req_duration
    ✓ 'p(95)<500' p(95)=212.4ms
    ✗ 'p(99)<1000' p(99)=1.42s
    http_req_failed
    ✓ 'rate<0.01' rate=0.31%

  █ TOTAL RESULTS
    ✗ status is 200
      ↳  99% — ✓ 2851 / ✗ 9
    http_req_duration..: avg=148ms min=41ms med=97ms max=3.1s p(95)=212ms
    http_req_failed....: 0.31%  9 out of 2860
    http_reqs..........: 2860   20.4/s
ERRO[0141] thresholds on metrics 'http_req_duration' have been crossed
# код выхода 99
Разбор: p95 в норме, p99 сорвался вместе с девятью не-200 ответами на полке в 60 VU — обычный пик сайт держит, тройной — нет. http_req_duration — это sending + waiting + receiving без DNS и соединения; чистый TTFB — http_req_waiting, TCP и TLS — http_req_connecting и http_req_tls_handshaking. Для теста «сколько RPS», а не «сколько пользователей» есть executor ramping-arrival-rate — его документация k6 рекомендует для breakpoint-теста вместе с abortOnFail.
Как запускать JMeter, Locust и Яндекс.Танк без GUI
JMeter собирают в GUI, а запускают из консоли: руководство пишет прямо — «GUI mode should only be used for creating the test script, CLI mode must be used for load testing». Флаг -n включает консольный режим, -t указывает план, -l пишет результаты, -e -o строят HTML-дашборд с APDEX (пороги 500 и 1 500 мс) и перцентилями 90/95/99.
jmeter -n -t shop.jmx -l results.jtl -e -o report/
# -Jusers=50 -Jduration=600 передают свойства в план,
# -r запускает тест на серверах из remote_hosts
# пример вывода (строки summary сокращены)
Creating summariser <summary>
Created the tree successfully using shop.jmx
Starting standalone test @ 2026-09-25 14:00:00 MSK
summary +   612 in 00:00:30 =  20.4/s Avg: 184 Min: 41 Max: 1902 Err: 0
summary +   615 in 00:00:30 =  20.5/s Avg: 191 Min: 39 Max: 2210 Err: 2
summary =  1227 in 00:01:00 =  20.4/s Avg: 187 Min: 39 Max: 2210 Err: 2
Locust описывает пользователя классом Python (HttpUser, методы с @task) и поднимает веб-интерфейс на порту 8089; для CI есть --headless с -u, -r и -t. Из-за GIL один процесс занимает одно ядро, поэтому документация предписывает --master и по одному --worker на ядро.
Яндекс.Танк задаёт профиль в RPS и умеет останавливаться сам. Схема line(1, 100, 10m) разгоняет с 1 до 100 запросов в секунду за 10 минут, const(100, 5m) держит полку, step(10, 100, 10, 60) поднимает нагрузку по 10 RPS каждые 60 секунд. Секция autostop прерывает тест по http(5xx, 10%, 10s) — 10 % ответов 5xx за 10 секунд — или time(1s, 10s), когда среднее время ответа выше секунды 10 секунд подряд; результаты выгружаются в Overload.
Как читать результат: график RPS против p95 и точка перегиба
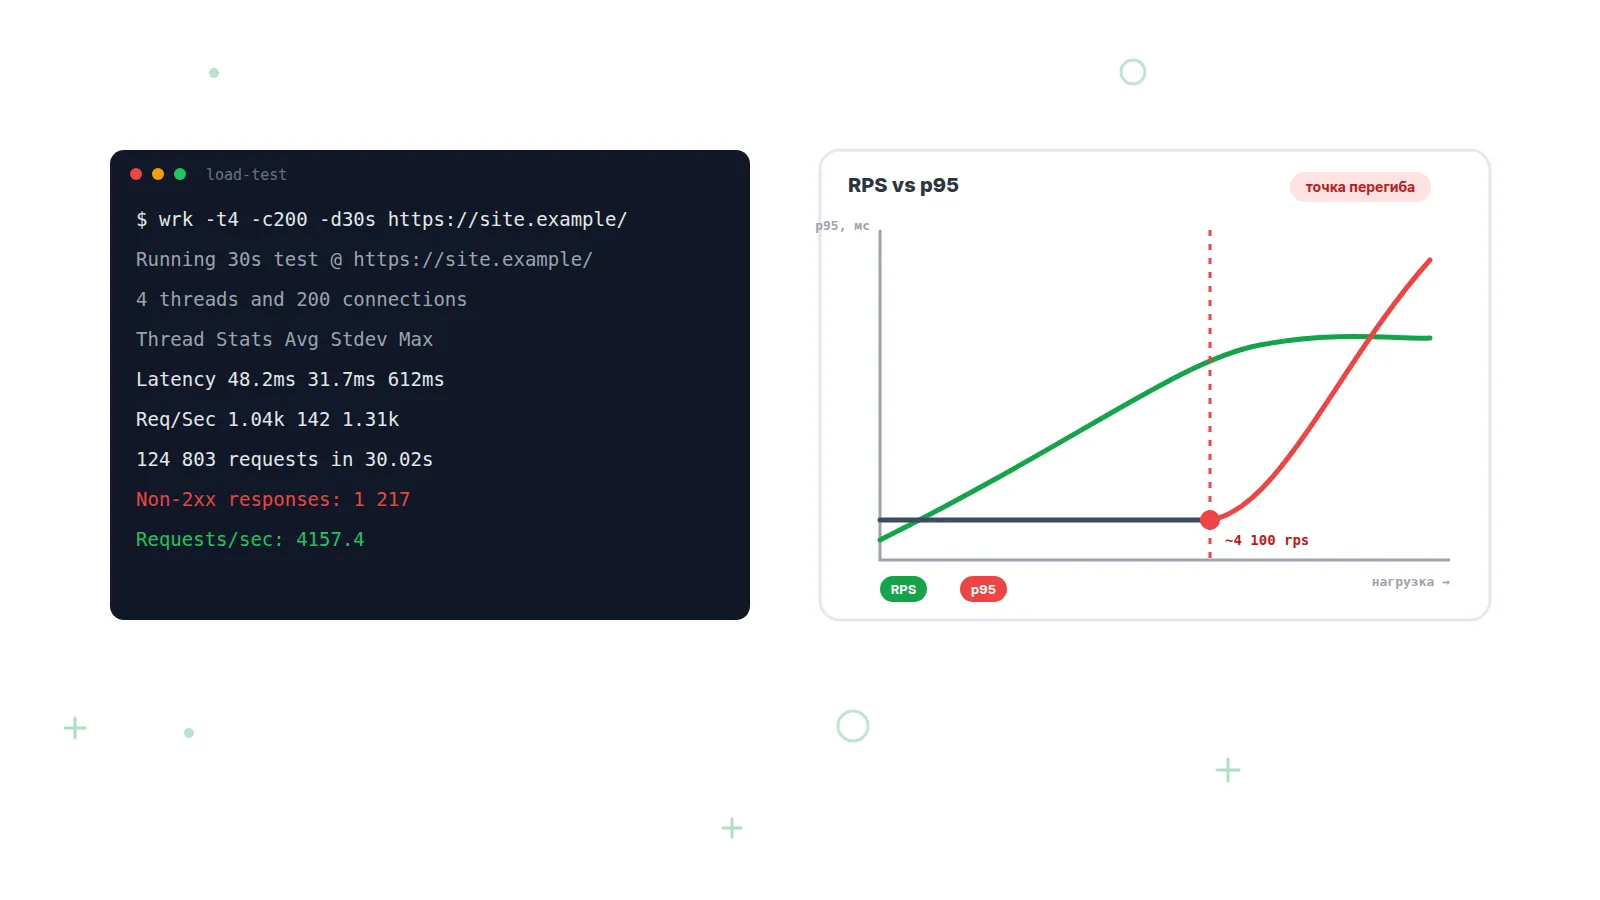
Предел сайта — не последняя ступень, на которой он ещё отвечал, а точка перегиба: нагрузка, после которой RPS перестаёт расти, а p95 растёт в разы. Рабочую ёмкость берут на 20–30 % ниже: на перегибе любая мелочь — бэкап, кроны, боты — уводит систему в ошибки.
Условный пример ступенчатого теста сайта на nginx и PHP-FPM с 8 воркерами, ступень — 3 минуты:
| Соединений | RPS | p50 | p95 | Ошибки | Что происходит |
|---|---|---|---|---|---|
| 10 | 210 | 40 мс | 70 мс | 0 | Линейный участок |
| 50 | 820 | 55 мс | 140 мс | 0 | Перегиб: p95 удвоился, CPU у PHP-FPM около 90 % |
| 100 | 910 | 100 мс | 380 мс | 0,2 % | Насыщение: вдвое больше соединений дали +11 % RPS |
| 200 | 900 | 210 мс | 1 400 мс | 3,1 % | Плато, растут 502 и 504: воркеры заняты |
| 400 | 640 | 560 мс | таймаут | 18 % | Коллапс: RPS падает, ресурсы уходят на очередь |
Цифры проверяет закон Литтла: L = λW, число запросов в системе равно произведению интенсивности на среднее время обслуживания — для любой стабильной системы независимо от распределений. Ступень 50: 50 = 820 × W, W ≈ 61 мс — совпадает с латентностью. Ступень 200: 200 / 900 = 222 мс — совпадает с p50. Следствие: для 900 RPS при p50 в 50 мс в системе должно быть 45 одновременных запросов, а не 200 — остальные стоят в очереди. После перегиба больше соединений даёт не RPS, а очередь.
Что чинить по результатам: keep-alive, кэш, воркеры, лимиты nginx и БД
Тип ошибки указывает на узкое место: 502 — упал или недоступен upstream, 504 — upstream жив, но не успел за таймаут, 503 — лимит соединений или защитный отказ, обрывы без кода — очередь accept или лимит открытых файлов.
| Симптом в тесте | Узкое место | Чем подтвердить | Что чинить |
|---|---|---|---|
| RPS низкий, CPU свободен, Connect в ab заметен | Нет keep-alive: каждый запрос — новое TCP/TLS-рукопожатие | ab с -k и без отличаются в разы | keepalive_timeout не 0 (по умолчанию 75s); keepalive к upstream |
| 502 и 504, CPU у PHP/Python 100 % | Мало воркеров приложения или запрос слишком тяжёлый | В логе FPM «server reached pm.max_children setting» | pm.max_children в пределах RAM, OPcache, кэш страниц и фрагментов |
| Обрывы, «worker_connections are not enough» в error.log | Лимит nginx: 512 соединений на воркер, включая upstream | ss -s растёт, ошибки в error.log | worker_connections 4096, worker_rlimit_nofile, worker_processes auto |
| p95 растёт, CPU веб-сервера свободен | База данных: медленные запросы, нет индексов, мал пул | slow query log, SHOW PROCESSLIST, pg_stat_activity | Индексы, кэш запросов, пул соединений, реплика на чтение |
| Секундные выбросы при свободных ресурсах | Переполнен accept backlog: у listen в nginx по умолчанию 511 | ListenOverflows в nstat -az растёт | listen ... backlog=4096 и net.core.somaxconn не меньше |
# /etc/nginx/nginx.conf — типичные правки после теста
worker_processes auto;
worker_rlimit_nofile 65535;

events {
    worker_connections 4096;   # по умолчанию 512
}

http {
    keepalive_timeout  75s;    # по умолчанию 75s; 0 отключает
    keepalive_requests 1000;   # по умолчанию 1000, до 1.19.10 — 100

    upstream app {
        server 127.0.0.1:9000;
        keepalive 32;          # кэш idle-соединений на воркер
    }

    server {
        listen 443 ssl backlog=4096;   # по умолчанию 511
        location / {
            proxy_pass http://app;
            proxy_http_version 1.1;    # нужно до nginx 1.29.7
            proxy_set_header Connection "";
        }
    }
}
После каждой правки тест повторяют с тем же профилем — иначе не отличить эффект от шума. Как разбирать 502 по логам nginx, описано в статье об ошибке 502 Bad Gateway; 504 отличается тем, что upstream жив, но не уложился в proxy_read_timeout.
Как связать нагрузочный тест с мониторингом до, во время и после
Генератор видит сайт из одной точки и только пока идёт тест; внешний мониторинг показывает, что видят пользователи из регионов, и продолжает смотреть после релиза. Практика: до теста снять базовую линию времени ответа по фазам (TCP, TLS, TTFB) из нескольких точек, во время теста наблюдать рост TTFB, после — оставить проверку с ожидаемым кодом ответа на реальный пик.
Пруфен опрашивает сайт из 20 точек мониторинга — 17 в России, а также Минск, Астана и Испания — и для каждого запуска сохраняет код ответа и время по фазам: во время теста видно, растёт ли TTFB для внешних клиентов и не отдаёт ли сайт 502 в регионах. HTTP-проверка с ожидаемым кодом 200 и интервалом от 2 минут откроет инцидент при росте ошибок после релиза и уведомит в Email, Telegram или Макс; частоту опроса поможет выбрать справка об интервалах проверок. Проверка «Скорость страницы» пригодится как замер до и после оптимизаций: она платная, но 150 ₽ при регистрации хватит на сравнение. Бесплатный план включает 5 проверок — начать можно с главной страницы Пруфена.
Как провести первое нагрузочное тестирование сайта
Порядок рассчитан на один вечер: нужна отдельная машина с ab или k6 и доступ к метрикам сервера.
- Определите целевую нагрузку: пиковый час из аналитики переведите в RPS (просмотры в час / 3 600) и умножьте на 2–3 — это цель стресс-теста.
- Согласуйте окно и адрес генератора с хостингом и провайдером защиты; тестируйте origin по IP с заголовком Host, на проде — в час минимального трафика.
- Снимите базовую линию: прогон на 5 соединениях 60 секунд, зафиксируйте p50, p95, RPS и ошибки.
- Откройте на сервере top, ss -s и логи ошибок nginx и приложения; включите внешние проверки времени ответа из нескольких точек.
- Наращивайте нагрузку ступенями по 2–3 минуты: 10, 50, 100, 200 соединений или соответствующие RPS в wrk2, k6 или Танке; записывайте RPS, p95 и ошибки на каждой ступени.
- Остановитесь, как только ошибки превысили 1 % или p95 вырос втрое от базовой линии: предыдущая ступень — перегиб, рабочая ёмкость на 20–30 % ниже.
- Определите узкое место по типу ошибки и метрикам сервера, внесите одну правку (keep-alive, воркеры, кэш, лимиты nginx, индекс) и повторите тот же профиль.
Частые вопросы
Сколько RPS должен выдерживать обычный сайт? Универсального числа нет: nginx отдаёт статику и закэшированные страницы десятками тысяч запросов в секунду, а один PHP-FPM-воркер тяжёлой CMS — единицы. Считайте от своего трафика: пиковый час, делённый на 3 600 и умноженный на 2–3. Для большинства сайтов малого бизнеса это десятки RPS, а не тысячи.
Чем стресс-тест отличается от нагрузочного, если оба подают трафик? Целью. Нагрузочный тест должен пройти: сайт держит ожидаемый пик, пороги по p95 и ошибкам выполнены. Стресс-тест подаёт нагрузку выше ожидаемой и заранее допускает деградацию — вопрос в том, насколько она плавная и восстанавливается ли сайт после снятия нагрузки. По руководству k6 стресс запускают только после успешных smoke- и average-load-тестов.
Почему ab показывает низкий RPS, а wrk на том же сервере — в разы больше? Из-за протокола: ab шлёт HTTP/1.0 и без -k открывает новое соединение на каждый запрос, wrk работает по HTTP/1.1 с постоянными соединениями и несколькими потоками. Разница — стоимость рукопожатий. Сравнивать нужно не инструменты, а ступени одного инструмента с одним профилем до и после правок.
Как понять, что во время теста сработала защита CDN, а не упал сайт? По коду и телу ответа: вместо 502 или 504 приходят 403, 429 или 503 со страницей челленджа, а время ответа становится подозрительно стабильным — защита отвечает быстрее приложения. Повторите запросы к origin по IP: если там всё в порядке, вы измеряли фильтр. Варианты 503 разобраны в статье об ошибке 503.