
 Дарья Лебедева
Случайный клоакинг: когда сайт отдаёт роботу не то, что людям, и как это проверить
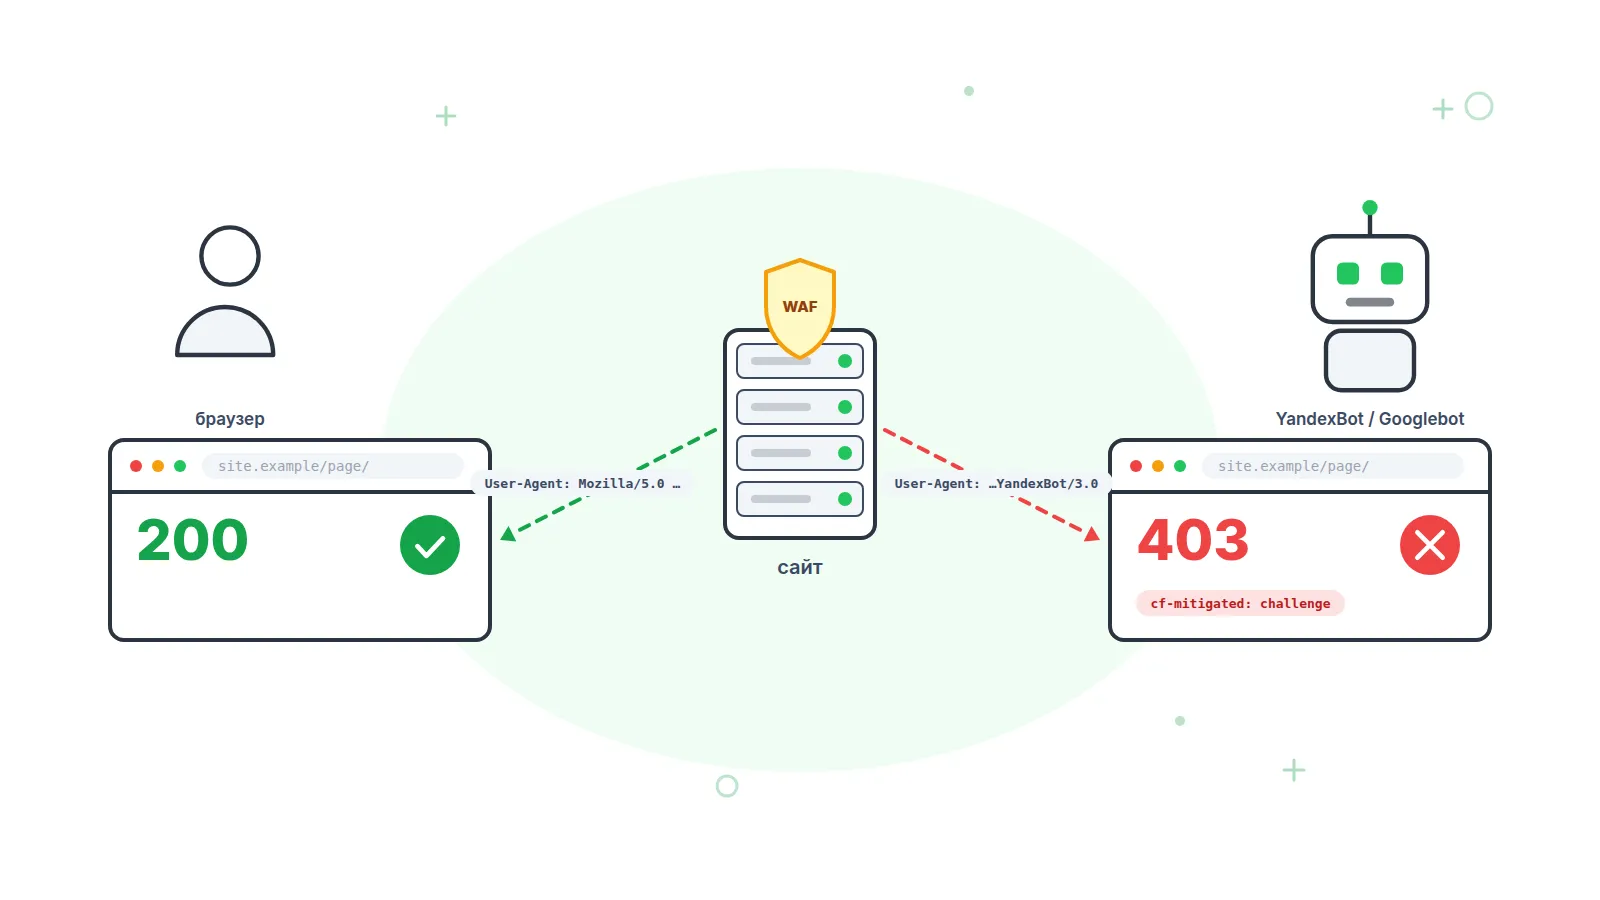
Клоакинг в учебниках — подмена страницы для поисковика ради накрутки. На практике чаще никто ничего не подменял, но антибот, кэш, гео-редирект или забытая ветка «if bot» отдают YandexBot и Googlebot не тот ответ, который видит посетитель. Разбираем, где это возникает, как проверить через curl и инструменты поисковиков и как поймать расхождение раньше, чем упадут позиции.
Случайный клоакинг — ситуация, когда сервер, WAF, CDN или кэш отдают поисковому роботу другой код ответа или другой контент, чем обычному посетителю, хотя владелец сайта этого не планировал. Алгоритмам поисковика намерение не видно: они сравнивают то, что получил робот, с тем, что получает пользователь. Google в Spam Policies определяет клоакинг как показ разного контента пользователям и поисковым системам с целью манипуляции выдачей; Яндекс — как «недобросовестный метод продвижения, когда посетителям и роботам поисковых систем на сайте отображается разный контент».
Чем случайный клоакинг отличается от намеренного и что за него бывает
Намеренный клоакинг — осознанная подмена: роботу отдают страницу про туризм, людям — про таблетки. Случайный — побочный эффект инфраструктуры, но на позициях сказывается так же: робот либо не получает страницу (403, 5xx, редирект), либо получает урезанную версию, и поисковик ранжирует именно её.
Санкции описаны в документации на сентябрь 2026. Google: сайты, нарушающие Spam Policies, «могут ранжироваться ниже или не появляться в результатах вовсе»; нарушения ловят автоматические системы, при необходимости — ручная проверка с manual action. Там же оговорки: пейволл не считается клоакингом, если Google видит полный контент, а взломанные сайты злоумышленники клоачат специально, чтобы владелец не заметил взлом. Яндекс относит клоакинг к девяти типам нарушений раздела «Безопасность и нарушения»; ограничения «могут влиять на ранжирование» сайта или отдельных разделов.
| Параметр | Google (Spam Policies) | Яндекс (справка Вебмастера) |
|---|---|---|
| Определение | Разный контент пользователям и поисковым системам с целью манипуляции ранжированием | Посетителям и роботам отображается разный контент; сюда же — сайт открывается только из поиска, по прямой ссылке отдаёт 404 |
| Не считается клоакингом | Пейволл с полным доступом для Googlebot и разметкой isAccessibleForFree; динамический рендеринг с тем же контентом | Временная недоступность, адаптивная вёрстка, контент по региону, A/B-тесты дизайна |
| Последствия | Понижение или исключение из выдачи; ручные меры в Search Console | Ограничения в ранжировании сайта или раздела; уведомление в «Безопасность и нарушения» |
| Как снимается | Исправить и отправить запрос на пересмотр из отчёта о ручных мерах | «Нарушение исправлено» → «Отправить на проверку»; проверка до 30 дней, повторно сообщить — только через 30 дней |
Случайный клоакинг редко доходит до статуса «нарушение» — срабатывает механизм проще: по документации Google обо всех кодах 4xx, кроме 429, краулер сообщает индексатору, что «контента не существует», и URL удаляется из индекса. То есть 403 от антибота убирает страницу из выдачи без всякого фильтра.
Откуда берётся случайный клоакинг: шесть типовых источников
Все шесть объединяет одно: где-то в цепочке «клиент → CDN → WAF → веб-сервер → приложение → кэш» есть ветвление по User-Agent, IP или cookie, и робот попадает не в ту ветку, что человек.
1. Антибот и WAF по User-Agent. Самый частый случай 2026 года — режимы защиты от ботов у CDN. Кейс от 13 августа 2026 (theinfinity.dev): после включения Bot Fight Mode на бесплатном плане Cloudflare показы сайта в Google упали с 1 153 в день до 16, средняя позиция — с 10,8 до 67,9 за шесть дней, с 6 по 12 августа. Googlebot получал 403 с заголовком cf-mitigated: challenge, а на странице челленджа стоял noindex,nofollow. В Search Console единственным ранним признаком была дата последнего сканирования, застывшая на 7 августа. Автор отключил режим (по документации Cloudflare обойти его WAF-правилами нельзя) и заменил правилом вида ip.src eq 203.0.113.10 and not cf.client.bot. Платный Super Bot Fight Mode допускает исключения через Skip, но ломается тоже: в теме на форуме Cloudflare от апреля 2026 владелец Pro-плана описывает 403 для Googlebot и 75 неудачных попыток сканирования при нуле разрешённых. Как те же правила режут не роботов, а систему мониторинга, — в статье «WAF блокирует мониторинг».
2. Отдельный кэш или prerender для роботов. Роботам — пререндеренный HTML, людям — SPA: это динамический рендеринг. Google на сентябрь 2026 пишет, что он «был обходным решением, а не долгосрочным», и рекомендует серверный или статический рендеринг. Клоакингом он не считается, пока роботу и людям отдаётся схожий контент; «полностью другой контент» — уже может считаться. Ломается двумя способами: рендер-сервер падает, и робот получает 5xx при живом сайте; или прокси кэширует ответ с ключом по User-Agent (заголовок Vary: User-Agent, механика — RFC 9111, раздел 4.1) и неделями раздаёт роботу устаревшую копию.
3. Гео-редиректы. По документации Google Googlebot сканирует в основном с IP-адресов в США и не передаёт Accept-Language; сканирование с адресов вне США существует как дополнение. Правило «пользователей из США — на /en/» отдаёт роботу английскую версию вместо русской, правило «не из России — 403» выключает индексацию целиком. Рекомендация Google: относиться к роботу из страны X как к любому пользователю оттуда, держать локали на разных URL с hreflang. Яндекс контент «в зависимости от региона пользователя» клоакингом не считает, но робот всё равно должен получить рабочую страницу.
4. Cookie-стены и пейволл. Робот приходит без cookie, поэтому логика «нет согласия — не показываем контент» или «нет сессии — редирект на /login» отдаёт ему заглушку. Google не считает пейволл клоакингом, если Googlebot видит полный контент, а закрытые фрагменты размечены isAccessibleForFree: false — разметка «помогает Google отличить платный контент от практики клоакинга».
5. Устаревшая ветка «if bot». Условие по $http_user_agent в nginx, middleware в приложении, правило в .htaccess — когда-то вели на prerender или «лёгкую» версию, сервис выключили, ветка осталась.
# nginx: ветка «для роботов», оставшаяся от старого prerender
location / {
    if ($http_user_agent ~* "(googlebot|yandexbot|bingbot)") {
        proxy_pass http://prerender:3000;
    }
    try_files $uri $uri/ /index.html;
}
# prerender давно остановлен: роботам уходит 502, людям — 200
6. Разные ответы CDN по регионам. Узлы CDN кэшируют независимо; после релиза часть узлов держит 404 или старую версию. Робот приходит на один узел, ваш браузер — на другой: не клоакинг по User-Agent, но по результату то же. Разбор с матрицей по 14 городам — в кейсе о региональных 404 на CDN.
| Источник | Симптом в Вебмастере / Search Console | Как проверить |
|---|---|---|
| Антибот / WAF по UA | GSC: «Заблокировано из-за запрещённого доступа (403)», застывшая дата сканирования; Вебмастер: рост ошибок HTTP в статистике обхода | curl -A с UA робота: 403 при 200 у браузера; события безопасности в панели WAF |
| Кэш / prerender по UA | GSC: пустой или устаревший скриншот в «Проверке URL», 5xx в отчёте о сканировании | diff HTML двух ответов; заголовки Vary, Age, X-Cache в ответе роботу |
| Гео-редирект | GSC: «Страница с переадресацией»; в выдаче английский тайтл у русской страницы | Запрос из зарубежной точки; Test live URL в GSC (сканирует из США) |
| Cookie-стена / пейволл | Индексируется текст баннера согласия; «Soft 404» в GSC; в Вебмастере «малоценная или маловостребованная» | curl без cookie: есть ли основной текст в HTML |
| Ветка «if bot» в конфиге | Массовые 5xx или 404 по данным поисковика при 100 % аптайме в своём мониторинге | grep по конфигам и коду: user_agent, bot, crawler |
| CDN по регионам | Вебмастер: часть страниц «Исключены — HTTP 404» при 200 из офиса; GSC: «Не найдено (404)» волнами после релизов | Запрос из нескольких регионов, сравнение кодов по локациям |
Как проверить руками: curl с User-Agent робота, diff и инструменты поисковиков
Минимальная проверка — три запроса curl к одному URL: как браузер, как YandexBot, как Googlebot, с выводом кода и размера тела. Разошлись код или размер — есть что искать.
# UA-строки — из официальных списков Яндекса и Google
UA_Y="Mozilla/5.0 (compatible; YandexBot/3.0; +http://yandex.com/bots)"
UA_G="Mozilla/5.0 (compatible; Googlebot/2.1; "
UA_G+="+http://www.google.com/bot.html)"
URL=https://site.example/catalog/

# код ответа, размер тела в байтах, адрес редиректа (если был)
chk() { curl -s -o /dev/null -A "$1" \
  -w "%{http_code}  %{size_download}  %{redirect_url}\n" "$2"; }

chk "Mozilla/5.0 (Windows NT 10.0; Win64; x64) Chrome/140.0" $URL
chk "$UA_Y" $URL
chk "$UA_G" $URL

# пример вывода: браузеру 200 и 48 КБ, роботам 403 и страница челленджа
200  48213
403  6811
403  6811
Второй вариант — код 200 у всех, но разное тело: роботу не отдали блок с ценами, поставили noindex или подсунули старую версию из кэша. Это видно только сравнением HTML.
# построчное сравнение: слева ответ роботу, справа — браузеру
diff <(curl -sA "$UA_G" $URL) <(curl -s $URL) | head -20

# пример вывода: роботу добавили noindex и убрали блок с ценами
5c5
< <meta name="robots" content="noindex,nofollow">
---
> <meta name="robots" content="index,follow">
212,240d211
< <section class="prices">
<   <h2>Цены</h2>
...

# только заголовки: кэш, Vary и признаки WAF
curl -sI -A "$UA_G" $URL | grep -iE 'vary|age|cf-'
# пример вывода
vary: User-Agent, Accept-Encoding
age: 86112
cf-mitigated: challenge
age: 86112 означает, что робот получил копию суточной давности; vary: User-Agent — что копий несколько и у робота своя. Третий шаг — инструменты поисковиков: они ходят со своих IP-адресов, а не с вашего.
| Инструмент | Чей IP и UA | Что показывает | Ограничение |
|---|---|---|---|
| curl -A | Ваш IP, любой UA | Код, заголовки, тело; полный diff | Не воспроизводит правила по IP |
| GSC → Проверка URL → Test live URL | IP Google, UA Google-InspectionTool | Скриншот, полученный HTML, HTTP-заголовки, консоль JS; поля Crawl allowed?, Page fetch, Crawled as | Дневной лимит live-проверок на ресурс |
| Вебмастер → Инструменты → Проверка ответа сервера | IP Яндекса, робот на выбор из списка | HTTP-код, статус SSL, поле If-Modified-Since | По справке, ответ «может отличаться от реального ответа роботу, так как инструмент имеет другой IP-адрес» |
| HTTP-проверка мониторинга с пресетом UA | IP точек мониторинга, UA YandexBot / Googlebot / свой | Код и время ответа по каждой точке на каждом запуске | Имитирует UA, не IP робота |
Какие User-Agent у роботов Яндекса и Google на сентябрь 2026
Для проверок нужны точные строки, потому что правила WAF и кэша матчат подстроки. Основной робот Яндекса представляется YandexBot/3.0, Google — Googlebot/2.1; полная строка Googlebot Smartphone выглядит как Chrome на Android, а Chrome/W.X.Y.Z в ней — плейсхолдер, версия растёт вместе с релизами Chromium. Строки — из справки Вебмастера «Роботы Яндекса в логах сервера» и списка краулеров Google.
| Робот | Строка User-Agent | Зачем нужен |
|---|---|---|
| YandexBot (основной) | Mozilla/5.0 (compatible; YandexBot/3.0; +http://yandex.com/bots) | Основной индексирующий робот; по той же схеме — YandexImages/3.0 и YandexVideo/3.0 |
| YandexMobileBot | Mozilla/5.0 (iPhone; CPU iPhone OS 8_1 like Mac OS X) AppleWebKit/600.1.4 (KHTML, like Gecko) Version/8.0 Mobile/12B411 Safari/600.1.4 (compatible; YandexMobileBot/3.0; +http://yandex.com/bots) | Определяет страницы с мобильной вёрсткой; robots.txt не учитывает |
| YandexRenderResourcesBot | Mozilla/5.0 (compatible; YandexRenderResourcesBot/1.0; +http://yandex.com/bots) | Загружает JS и CSS для рендеринга страниц — блокировка ломает отрисовку |
| Googlebot Smartphone | Mozilla/5.0 (Linux; Android 6.0.1; Nexus 5X Build/MMB29P) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/W.X.Y.Z Mobile Safari/537.36 (compatible; Googlebot/2.1; +http://www.google.com/bot.html) | Основной робот при mobile-first индексации |
| Googlebot Desktop | Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; Googlebot/2.1; +http://www.google.com/bot.html) Chrome/W.X.Y.Z Safari/537.36 Реже: Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html) |
Десктопное сканирование; короткая форма удобна для curl |
| Googlebot-Image / Googlebot-Video | Googlebot-Image/1.0 Googlebot-Video/1.0 |
Картинки и видео; строка без Mozilla — правила «UA без Mozilla = бот» режут их первыми |
| Google-InspectionTool | Mozilla/5.0 (compatible; Google-InspectionTool/1.0) | «Проверка URL» в Search Console |
Вывод из таблицы: правило «блокировать UA без слова Mozilla» отсекает Googlebot-Image и Googlebot-Video, правило «UA содержит bot — капча» ловит всех сразу. Robots.txt не спасает: он управляет обходом, а не тем, что робот получит в ответе. Как за ним следить — в статье о robots.txt.
Как отличить настоящего робота от имитации и почему подмена UA не равна IP
Строку User-Agent подставит кто угодно, поэтому обе поисковые системы верифицируют робота по IP через обратный и прямой DNS. Отсюда и обратное: curl -A и HTTP-проверка с пресетом UA воспроизводят только правила по строке UA, правила по IP-диапазонам и reverse DNS — нет.
Процедура одинаковая, различаются допустимые домены. Google: обратная запись оканчивается на googlebot.com, google.com или googleusercontent.com, прямой запрос имени возвращает исходный IP. Яндекс: имена роботов оканчиваются на yandex.ru, yandex.net или yandex.com; роботы работают из автономных систем AS13238, AS208722 и AS212066, список IP не публикуется — вместо него в Вебмастере есть инструмент проверки IP. Google диапазоны публикует в JSON: common-crawlers.json для поисковых роботов (бывший googlebot.json — старый адрес на сентябрь 2026 отдаёт 301 на новый), special-crawlers.json и три файла user-triggered-* для остальных фетчеров; адреса в формате CIDR.
# обратный DNS (PTR), затем прямой — имя должно вернуть тот же IP
dig -x 66.249.66.1 +short
# пример вывода из документации Google
crawl-66-249-66-1.googlebot.com.
dig crawl-66-249-66-1.googlebot.com +short
66.249.66.1

# а это «YandexBot», который Яндексом не является
dig -x 203.0.113.5 +short
# пример вывода: домен не yandex.ru/.net/.com — имитация
scanner-203-0-113-5.example-hosting.net.
Отсюда правило для WAF: исключения для роботов строить по верифицированным спискам (у Cloudflare — категория Verified bots и поле cf.client.bot, у собственного nginx — geo-списки из JSON Google), а не по подстроке в UA. Иначе исключение откроет дверь любому сканеру с поддельной строкой.
Как контролировать расхождение постоянно, а не разовым curl
Разовая проверка ловит клоакинг только в момент запуска, а он появляется в день релиза или включения защиты «на выходные из-за скрейперов». Рабочая схема — две-три параллельные HTTP-проверки одного URL с одинаковым интервалом и набором точек: одна с браузерным User-Agent, вторая с пресетом YandexBot или Googlebot в настройках HTTP-проверки, и сравнение результатов.
| Что сравнивать | Норма | Расхождение = сигнал | Типичная причина |
|---|---|---|---|
| Код ответа | Одинаковый у всех UA на всех точках | 200 у браузера, 403 / 429 / 503 / 30x у робота | WAF, гео-редирект, мёртвый prerender |
| Размер ответа | Разница в пределах сотен байт (токены, nonce) | Разница в разы | Страница челленджа, cookie-стена |
| Наличие контента | Ключевая фраза (H1, цена) есть в обоих ответах | Есть у браузера, нет у робота | Пустой шаблон prerender, старая копия в кэше |
| Время ответа | Сопоставимое | У робота стабильно в разы дольше | Рендер-сервер или JS-челлендж |
| Разброс по точкам | Все точки видят одно и то же | Ошибка у робота только из части регионов | Региональный кэш CDN, гео-правила WAF |
Наличие контента проверяется отдельным типом проверки: проверка наличия контента ищет заданную фразу в теле ответа и открывает инцидент, если её нет, — это ловит подмену при коде 200. Достаточно одной фразы, которой нет в шаблоне и на странице челленджа: название товара, цена, номер лицензии.
HTTP-проверка запускается из 20 точек мониторинга — 17 в России, а также Минск, Астана и Испания — с интервалом от 2 минут. В настройках есть пресеты User-Agent YandexBot и Googlebot и поле для произвольной строки: один URL ставится на три параллельные проверки — браузер, робот Яндекса, робот Google. Вкладка «По локациям» показывает код ответа каждой точки на каждом запуске: расхождение «200 у браузерной проверки, 403 у роботной» видно в матрице сразу, региональный клоакинг — как ошибка только в части городов. Пороги открытия и закрытия инцидента настраиваются отдельно, уведомления приходят на Email, в Telegram и Макс; если ресурс так и не поднялся, подключается голосовой звонок. Результаты по каждой точке доступны через REST API. Бесплатный план — 5 проверок, при регистрации на счёт начисляется 150 ₽. Поставить страницы на проверку от имени робота.
Как проверить сайт на случайный клоакинг: чек-лист
Порядок: сначала проверки снаружи, затем поиск ветвлений внутри, затем постоянный контроль.
- Соберите 10–30 URL: главная, по одной странице каждого шаблона, страницы с наибольшим трафиком из Вебмастера и Search Console.
- Для каждого URL выполните три запроса curl — с браузерным UA, с YandexBot/3.0 и с Googlebot/2.1 — и запишите код, размер тела и адрес редиректа. Расхождение кода или разница размера больше нескольких сотен байт — кандидат на разбор.
- Для URL с одинаковым кодом 200 сделайте diff HTML робота и браузера: ищите noindex, отсутствующие блоки, другой язык, заголовки vary: User-Agent и age в ответе роботу.
- Прогоните те же URL через «Проверку URL» в Search Console (Test live URL → View crawled page) и «Проверку ответа сервера» в Вебмастере с выбором основного робота — это запросы с IP поисковиков, они покажут правила по IP и гео.
- Проверьте панель WAF или CDN: режимы антибота, правила «UA содержит bot», гео-блокировки, JS-челлендж для всех. Исключение для роботов — по категории верифицированных ботов, а не по строке UA.
- Найдите ветвления в конфигурации и коде: grep по nginx, Apache, middleware и шаблонам на user_agent, bot, crawler, prerender, geoip. Каждую ветку либо удалите, либо убедитесь, что она отдаёт тот же контент.
- Сверьте логи за неделю: сгруппируйте запросы с UA роботов по коду ответа. Доля не-200 у робота выше, чем у остальных клиентов, — это и есть случайный клоакинг в цифрах. IP роботов проверьте через обратный DNS.
- Поставьте постоянный контроль: на 5–10 ключевых URL по три HTTP-проверки с разными UA из нескольких регионов плюс проверку наличия контента. Повторяйте пункты 2–4 после каждого релиза.
Частые вопросы
Считается ли клоакингом, если робот получает 403 от антибота, а не другой контент? Формально это не подмена контента, и фильтр за клоакинг маловероятен. Но результат хуже: по документации Google коды 4xx, кроме 429, означают для индексатора «контента не существует», и URL удаляется из индекса. В кейсе августа 2026 именно так показы упали с 1 153 до 16 в день без единого уведомления о нарушении.
Динамический рендеринг и prerender для ботов — это клоакинг? По документации Google — «как правило, нет», если роботу и людям отдаётся схожий контент; «полностью другой контент» уже может быть расценён как клоакинг. Если prerender есть, держите его под мониторингом с UA робота: его падение люди не заметят никогда.
Почему curl -A показывает 200, а Search Console — ошибку? curl подставляет только строку User-Agent, IP остаётся вашим. Правила по IP-диапазонам, обратному DNS и геолокации срабатывают только на настоящий запрос с адресов Google или Яндекса. curl отвечает на вопрос «есть ли ветвление по UA», инструменты поисковиков — «что робот получает на самом деле». Нужны оба.
Через сколько восстановятся позиции после исправления? Гарантированных сроков нет. Google перепроверяет URL по расписанию обхода — автор кейса с Bot Fight Mode советует следить за датой последнего сканирования в «Проверке URL». У Яндекса после кнопки «Отправить на проверку» перепроверка занимает до 30 дней, повторно сообщить о том же нарушении можно только через 30 дней. Дешевле поймать расхождение в первые минуты после релиза, чем ждать перепроверки неделями.