
 Команда Пруфена
Кейс: региональные 404 на CDN выбивали страницы из топ-10, а из Москвы сайт выглядел здоровым
Крупный контентный портал с 500 000+ страниц в индексе поставил на мониторинг 5 000 трафиковых URL из всех регионов. Через несколько недель матрица «По локациям» и данные проверок, выгруженные по API в SEO-дашборд, показали то, чего не видел ни один внутренний график: в части регионов CDN отдавал 404 вместо 200, и именно эти страницы выпадали из топ-10 Яндекса и Google. Разбираем, как это нашли, при чём тут проверки от имени YandexBot и API, почему так происходит и сколько это стоит по мировым данным.
Региональная 404 — ситуация, когда одна и та же страница отдаёт код 404 пользователям и поисковым роботам в одних регионах и 200 в других. Причина почти всегда в распределённой доставке: узлы CDN кэшируют ответ независимо друг от друга, и при обновлении часть узлов получает ошибку и раздаёт её несколько минут или часов. Мониторинг из одного города такую ошибку не видит по определению — он попадает на «здоровый» узел.
Что поставили на мониторинг и зачем
Клиент — крупный контентный портал, работает на всю Россию, в индексе Яндекса и Google больше полумиллиона страниц. Основной канал — органический поиск, поэтому SEO-команда хотела не аптайм главной страницы, а ответ на вопрос «какие из наших трафиковых страниц прямо сейчас отдают не 200 и где». Мониторить все 500 000 URL смысла нет: взяли 5 000 страниц, которые приносят основную долю поискового трафика, по всем направлениям сайта — разделы каталога, информационные статьи, сервисные страницы.
| Параметр | Как настроили | Почему так |
|---|---|---|
| Объём | 5 000 URL из 500 000+ в индексе | Страницы с основной долей органического трафика, по всем разделам |
| Тип проверки | HTTP GET с ожидаемым кодом 200, часть URL — дополнительно с User-Agent YandexBot и Googlebot | Нужен именно код ответа страницы, а не «сервер жив» по ping |
| Вторая проверка | Скорость страницы (Google PageSpeed) на части URL | Ловить деградацию скорости после релизов |
| Точки | Все доступные локации мониторинга | Аудитория — вся страна, значит и смотреть надо со всей страны |
| Интервал | 15 минут | Компромисс между скоростью обнаружения и стоимостью 5 000 проверок |
| Порог инцидента | По умолчанию: инцидент, когда ошибку видит 80 % точек | Ниже порога — «частичный сбой», он остаётся в матрице, но не будит дежурного |
Важная деталь: изначально это был инструмент SEO-отдела, а не эксплуатации. Инженеры клиента смотрели на свои метрики — origin-серверы, балансировщики, ошибки приложения — и там всё было зелёным. Именно поэтому проблема, о которой ниже, жила незамеченной.
Что показала матрица «По локациям»
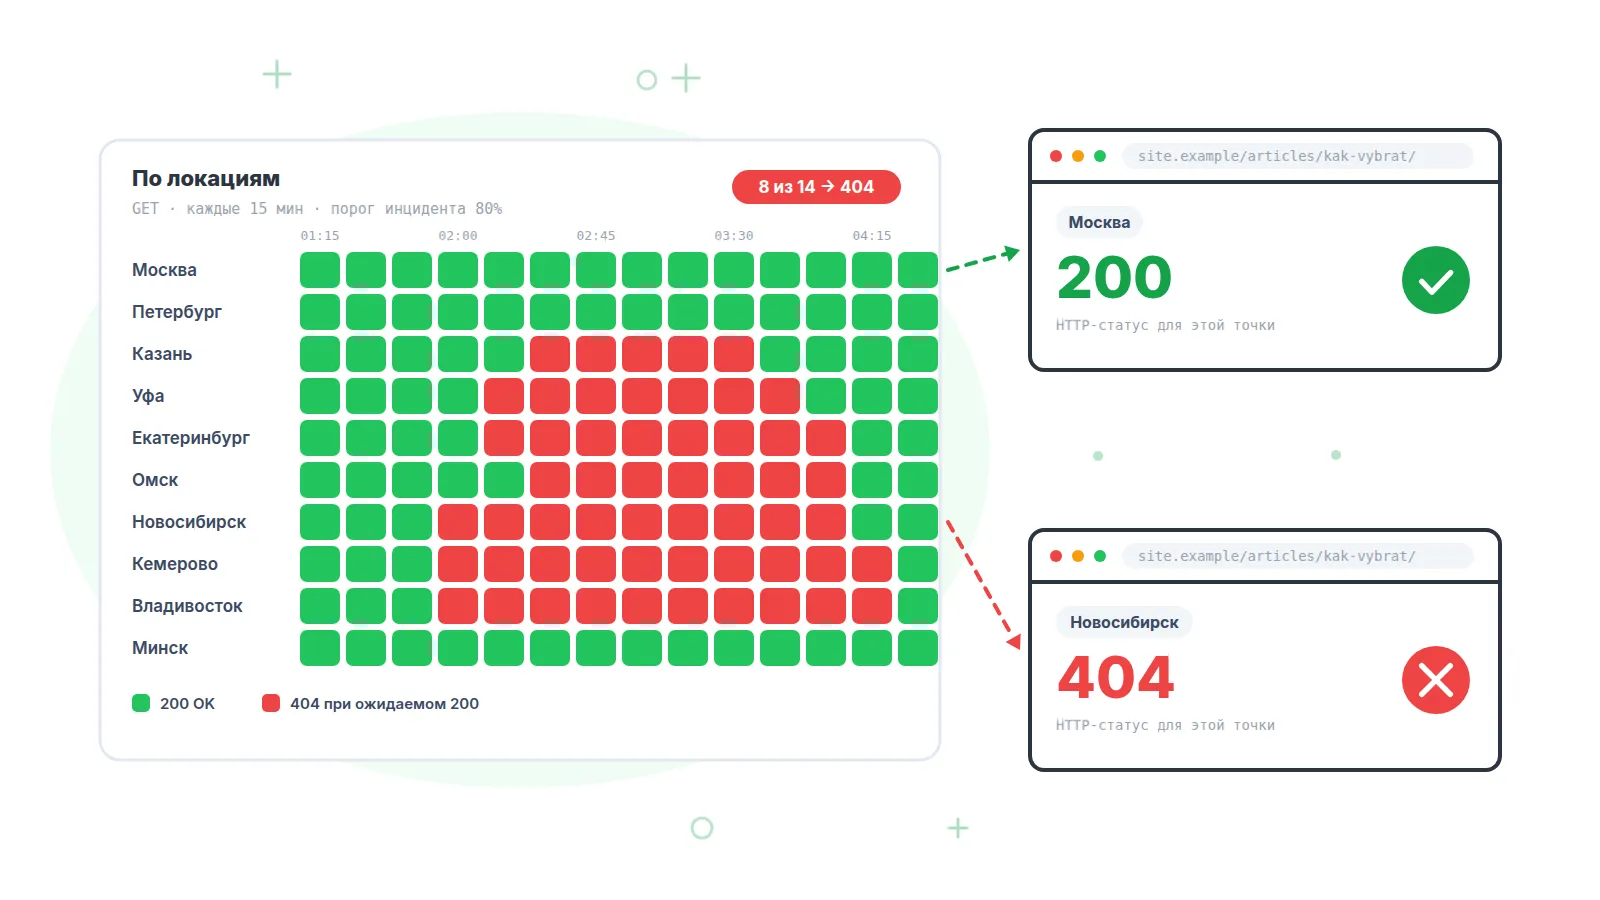
Через несколько недель по части категорий и отдельным страницам стали появляться инциденты с кодом 404 — сначала редкие, потом сериями. Когда SEO-специалист открыл вкладку «По локациям», картина была не похожа на «сайт упал»: Москва, Петербург, Минск и Испания видели страницу с кодом 200 на каждом запуске, а Сибирь, Урал и Дальний Восток в это же время получали 404. Ниже — схема по мотивам реальной матрицы: 14 городов, 16 запусков с шагом 15 минут, одна страница.
| 01:15 | 02:00 | 02:45 | 03:30 | 04:15 | 05:00 | ok, % | |||||||||||
| Москва | 100% | ||||||||||||||||
| Петербург | 100% | ||||||||||||||||
| Краснодар | 100% | ||||||||||||||||
| Казань | 69% | ||||||||||||||||
| Уфа | 56% | ||||||||||||||||
| Екатеринбург | 50% | ||||||||||||||||
| Омск | 56% | ||||||||||||||||
| Новосибирск | 44% | ||||||||||||||||
| Кемерово | 38% | ||||||||||||||||
| Владивосток | 33% | ||||||||||||||||
| Мурманск | 81% | ||||||||||||||||
| Минск | 100% | ||||||||||||||||
| Астана | 100% | ||||||||||||||||
| Испания | 100% | ||||||||||||||||
| 404 из 14 | · | · | · | 3 | 5 | 7 | 8 | 8 | 8 | 7 | 6 | 5 | 2 | · | · | · |
ok — код 200 сбой — код 404 при ожидаемом 200 не участвовала — точку подменила другая
На пике ошибку видели 8 точек из 14 — 57 %. Порог инцидента 80 % не пройден, поэтому уведомление не ушло, но каждый такой запуск записан как «запуск с частичным сбоем», и в карточке проверки их накопились десятки. По другим URL той же категории ошибку видели почти все точки, там инциденты открывались и приходили в Telegram. Аптайм из Москвы по всем этим страницам был 100 %.
Ключевое свойство региональной ошибки видно в правой колонке: у «плохих» городов доступность 33–81 %, у «хороших» — 100 %. Если бы мониторинг стоял только в Москве, столбец был бы единственным, и в нём стояло бы 100 %.
Пруфен как поставщик данных: проверки уехали в SEO-дашборд по API
Уведомления в Telegram — только половина истории. У SEO-команды клиента был свой большой дашборд: позиции по кластерам запросов, трафик из Метрики и Search Console, видимость по регионам. Туда же они начали забирать результаты проверок через API Пруфена. Это ключевой момент кейса: мониторинг использовали не как «звонок, когда упало», а как ещё один источник данных, который лежит рядом с позициями и трафиком и джойнится с ними по URL и дате.
Сами 5 000 проверок тоже создали через API, а не руками: список URL выгрузили из своей системы, для каждого — POST на создание проверки с нужными локациями, интервалом и ожидаемым кодом. Дальше раз в час скрипт обходил проверки и забирал историю результатов: у каждой записи есть локация, код ответа, флаг успеха и разбивка времени ответа по фазам.
# создать проверку: все локации, 15 минут, ждём код 200
curl -X POST https://app.prufen.ru/api/v1/checks \
  -H "Authorization: Bearer $PRUFEN_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{"project_name":"SEO: трафиковые страницы",
       "name":"/articles/kak-vybrat/",
       "address":"site.example/articles/kak-vybrat/",
       "type":"curl","protocol":"https",
       "location_ids":["<uuid-1>","<uuid-2>","..."],
       "frequency_in_min":15,"expected_status_code":200,
       "start_incident_threshold_percent":80,
       "end_incident_threshold_percent":80}'

# забрать историю результатов проверки (с пагинацией)
URL="https://app.prufen.ru/api/v1/checks/<check-uuid>/results"
curl -s "$URL?per_page=250" \
  -H "Authorization: Bearer $PRUFEN_TOKEN"
# пример ответа (сокращён)
{"data":[{"location_id":"<uuid-nsk>","status_code":404,"is_ok":false,
          "total":0.181,"created_at":"2026-08-21T02:15:04+00:00"},
         {"location_id":"<uuid-msk>","status_code":200,"is_ok":true,
          "total":0.236,"created_at":"2026-08-21T02:15:02+00:00"}],
 "meta":{"current_page":1,"last_page":5,"per_page":250}}
В хранилище клиента из этого получилась плоская таблица «дата × URL × локация × код ответа», а из неё — две агрегированные метрики на каждый URL и день: доля запусков с ошибкой и доля локаций, видевших 404. Рядом легли позиции и клики. Именно такая витрина и позволила увидеть корреляцию, о которой ниже: в отчёте по кластеру запросов появилась колонка «404 по регионам», и просадки перестали быть загадкой.
| Источник | Поле | Как использовали в дашборде |
|---|---|---|
| Пруфен, /results | location_id, status_code, is_ok, created_at | Доля локаций с 404 на URL за день; матрица «регион × день» |
| Пруфен, /results | dns_lookup, tcp_connection, tls_connection, total | Время ответа по регионам — отдельный сигнал деградации после релизов |
| Пруфен, /incidents | reason, started_at, ended_at | Маркеры инцидентов на графике позиций; reason содержит код ответа |
| Пруфен, /overview | uptime за 24 ч / 7 / 31 день | Сводный аптайм по разделам сайта для еженедельного отчёта |
| Сервис позиций | URL, запрос, позиция, дата, регион | Целевая метрика: вход/выход из топ-10 по Яндексу и Google |
| Метрика / Search Console | URL, клики, показы, дата | Денежное выражение просадки по кластеру |
Порог инцидента при таком подходе становится второстепенным: даже если 8 точек из 14 не дотягивают до 80 % и уведомление не уходит, в витрине эти запуски есть, и аналитик видит их на следующее утро. Мониторинг с несколькими точками для этого и нужен — не «упал / не упал», а ответ каждой точки как самостоятельная строка данных.
Как SEO-команда связала 404 с выпадением из выдачи
Связь нашли не мы, а клиент — в том самом дашборде. SEO-специалист еженедельно сводил позиции по кластерам запросов и заметил, что просадки не случайные: проседали ровно те разделы, по которым в колонке «404 по регионам» стояли серии ошибок. Наложили даты эпизодов 404 по локациям на даты, когда страницы теряли топ-10 в Яндексе и Google, — и получили закономерность, которая повторилась несколько раз.
| Этап | Что происходит | Как это выглядит у клиента |
|---|---|---|
| День 0 | После обновления контента часть узлов CDN начинает отдавать 404 на группу страниц | В матрице краснеют Урал, Сибирь, Дальний Восток; Москва зелёная |
| Часы — сутки | Робот Яндекса или Google приходит на страницу и попадает на «плохой» узел, получает 404 | В логах origin ничего: запрос до него не дошёл, ответ отдал кэш CDN |
| Дни 1–3 | Поисковик считает страницу удалённой и начинает исключать её из индекса | Страницы категории уходят из топ-10, трафик по кластеру падает |
| Дни 3–7 | Кэш на узлах давно обновился, страница снова отдаёт 200 везде | Инженеры воспроизвести проблему не могут: «у нас всё 200» |
| Недели | Робот переобходит страницу, убеждается в 200, возвращает в индекс | Позиции возвращаются не сразу и не всегда на прежнее место |
Сроки в таблице — не догадка, а документированное поведение поисковиков. Справка Яндекс.Вебмастера: если страница отвечает 404, 403 или 410, она удаляется из поисковой базы в течение недели после того, как робот это обнаружит, а возврат после исправления может занять до трёх недель. Документация Google Search Central: уже проиндексированные URL, отдающие 4xx, удаляются из индекса; Джон Мюллер уточнял, что при 404 Google начинает выкидывать URL «через пару дней, поштучно», а возвращение после восстановления занимает «неделю-две». При этом обе системы относятся к 5xx мягче: серверная ошибка воспринимается как временная, и страница какое-то время сохраняется в индексе. Именно поэтому региональная 404 опаснее регионального 500.
| Поисковик | Реакция на 404 | Реакция на 5xx / 503 | Возврат после исправления |
|---|---|---|---|
| Яндекс | Удаление из базы в течение недели после обнаружения | Страница исключается по мере обхода; при затяжных ошибках сайт может пропасть целиком | До трёх недель (справка), обычно в пределах двух после переобхода |
| Проиндексированные URL с 4xx удаляются; начало — «через пару дней», поштучно | Обход замедляется, URL сохраняются, но при длительных 5xx выпадают; 503 повторно проверяется около недели | «Неделя-две» по словам Джона Мюллера |
Мы несколько месяцев не понимали, почему кластеры проседают «сами по себе». Матрица по регионам дала первую версию, которая объяснила все эпизоды сразу — и уже дважды спасла нас от разбора полётов, где виноватым было бы SEO.
— из переписки с SEO-командой клиента, в пересказе
Почему CDN отдавал 404 только в части регионов
Разбор показал не «падение CDN», а штатную механику кэширования, наложенную на процесс обновления контента. Сайт большой, страницы раздаются через CDN с десятками узлов по стране, и у каждого узла свой кэш. При массовом обновлении часть запросов к origin в короткое окно получала 404 — страница переезжала, менялся роутинг, не успевал прогреться новый релиз, конкретная причина в каждом эпизоде была своя. Дальше срабатывали три свойства любой CDN.
| Свойство CDN | Что это значит на практике | Документированные значения |
|---|---|---|
| Независимый кэш на каждом узле | Узел в Новосибирске и узел в Москве не знают друг о друге: промах в одном не заполняет другой | Cloudflare прямо пишет: каждый дата-центр работает независимо, промах в одном — отдельный запрос к origin |
| Негативное кэширование | Ответ 404 тоже кэшируется, и узел раздаёт его до истечения TTL, даже если origin уже отдаёт 200 | Cloudflare — 404 и 410 по умолчанию 3 минуты; AWS CloudFront — 404, 500, 502, 503, 504 минимум 10 секунд; nginx кэширует ошибки, если они перечислены в proxy_cache_valid |
| Очистка кэша не мгновенная | После фикса purge доходит до узлов не одновременно; часть узлов ещё какое-то время отдаёт старый ответ | Selectel CDN и Yandex Cloud CDN: очистка занимает до 15 минут; Cloudflare после переделки purge — доли секунды, но это исключение |
Сложите это вместе: окно ошибки на origin длиной в минуту превращается на разных узлах в 3, 10, 15 минут закэшированной 404 — и не на всех узлах сразу, а на тех, куда за эту минуту пришёл хотя бы один запрос. Робот Яндекса, пришедший на страницу в это время через «плохой» узел, получил 404 и запомнил. А анти-ддос-защита и правила WAF, о которых мы писали в статье про блокировку мониторинга, к этому кейсу отношения не имели: коды были честные, просто региональные.
Проверить конкретный узел CDN руками можно, минуя DNS и заставив curl пойти на нужный IP. Так инженеры клиента впоследствии воспроизводили проблему на «плохих» узлах, пока Москва отдавала 200:
# IP узлов CDN — из ответов DNS с разных резолверов
dig +short site.example @77.88.8.8
dig +short site.example @1.1.1.1

# запрос к конкретному узлу, минуя DNS
curl -sI --resolve site.example:443:203.0.113.10 \
  https://site.example/articles/kak-vybrat/ | head -3
# пример вывода с "плохого" узла
HTTP/2 404
age: 137
cache-status: cdn; hit

# и с "хорошего"
HTTP/2 200
age: 12
cache-status: cdn; hit
Заголовок age в ответе — сколько секунд ответ лежит в кэше узла. Если на 404 он растёт, вы смотрите на негативный кэш: origin, скорее всего, уже давно в порядке.
Почему мониторинг из Москвы этого не увидит никогда
Потому что московская точка мониторинга, московский офис клиента и робот Яндекса, который приходит из сетей Яндекса в Москве, попадают на одни и те же «здоровые» узлы, а аудитория за Уралом — на другие. Роботы поисковиков географически привязаны: справка Яндекса указывает, что роботы работают из автономных систем AS13238, AS208722 и AS212066, IP которых не публикуются; Google в документации по locale-adaptive страницам пишет, что адреса Googlebot по умолчанию расположены в США, и лишь часть обхода идёт с адресов в других странах. Ни один из них не обязан попасть на тот же узел, что ваш мониторинг.
| Кто запрашивает страницу | Откуда приходит | Какой узел CDN получает | Что видит в кейсе |
|---|---|---|---|
| Пользователь из Новосибирска | Сеть регионального оператора | Узел в Сибири | 404 |
| Пользователь из Москвы | Московский оператор | Узел в Москве | 200 |
| Робот Яндекса | AS Яндекса, Москва | Зависит от маршрута — не обязательно московский узел | 404 на части обходов |
| Googlebot | Преимущественно США | Внешний узел или узел ближайшего входа в Россию | 404 на части обходов |
| Мониторинг из одной точки | Один дата-центр в Москве | Один и тот же узел каждый раз | 200, аптайм 100 % |
| Мониторинг из 20 точек | Города по всей стране и за её пределами | Разные узлы, включая «плохие» | 404 на 8 точках из 14, история по каждой |
| Мониторинг из 20 точек с UA робота | Те же города, но запрос представляется YandexBot или Googlebot | Те же узлы плюс ветки «для роботов» в WAF, кэше и рендере | Разница кодов «браузер / робот» по каждой точке |
Региональный характер сбоев — не особенность российских CDN, а норма для распределённых систем. ThousandEyes по итогам 2025 года формулирует это прямо: отказы инфраструктуры обычно региональны и задевают часть клиентов, тогда как ошибки конфигурации бьют по всем регионам сразу. Мы разбирали арифметику пропущенных сбоев в статье про мониторинг из одной точки; этот кейс — её практическое подтверждение с ценником в позициях.
Второй взгляд: та же страница от имени YandexBot и Googlebot
Регион — не единственное, по чему сайт может отвечать по-разному. Второе измерение — кто спрашивает. Антибот-правила WAF, отдельный кэш «для роботов», серверный рендеринг только для поисковиков, редиректы по User-Agent — всё это отдаёт роботу не тот ответ, что браузеру, и снаружи выглядит как «у нас всё открывается». Поэтому часть проверок клиент продублировал с User-Agent поискового робота: в настройках HTTP-проверки Пруфена есть пресеты YandexBot и Googlebot, можно вписать и любую свою строку. Одна и та же страница, те же точки, тот же интервал — но одна проверка ходит как браузер, вторая как робот Яндекса, третья как Googlebot.
| Что отвечает роботу иначе | Как это выглядит | Что ловит проверка с UA робота |
|---|---|---|
| Антибот и WAF по User-Agent | Строка «bot» в UA попадает под правило: 403, капча или challenge-страница с noindex | Код не 200 только у «роботной» проверки, у браузерной всё зелёное |
| Отдельный кэш для роботов | CDN или прокси держит вариант страницы по UA (Vary: User-Agent, prerender для ботов) — и кэширует его отдельно, в том числе 404 | Региональная 404 у «роботной» проверки при 200 у браузерной на той же точке |
| Серверный рендеринг только для ботов | Пользователь получает SPA и JS, робот — HTML с сервера; при сбое рендера робот получает 5xx или пустой ответ | Разница во времени ответа и коде между двумя проверками |
| Случайный клоакинг после релиза | Ветка кода «если робот — то…» сломалась: редирект на главную, устаревшая версия, 404 | Одна и та же страница — два разных кода в одном запуске |
Честная оговорка: такая проверка имитирует только User-Agent. IP-адрес остаётся адресом точки мониторинга, а не сетей Яндекса или Google, поэтому правила, которые проверяют робота по обратному DNS или по диапазону IP, она не воспроизведёт. Зато всё, что завязано на строку UA — а это большинство антибот-правил, кэш-ключей и веток серверного рендеринга, — видно сразу. Проверить руками ту же логику можно двумя запросами curl:
# как браузер
curl -sI https://site.example/articles/kak-vybrat/ | head -1
# как робот Яндекса
curl -sI -A "Mozilla/5.0 (compatible; YandexBot/3.0; \
  +http://yandex.com/bots)" \
  https://site.example/articles/kak-vybrat/ | head -1
# как Googlebot
curl -sI -A "Mozilla/5.0 (compatible; Googlebot/2.1; \
  +http://www.google.com/bot.html)" \
  https://site.example/articles/kak-vybrat/ | head -1
# пример вывода: браузеру 200, роботам 403 - правило WAF по UA
HTTP/2 200
HTTP/2 403
HTTP/2 403
В кейсе «роботные» проверки дали ещё один слой данных для дашборда: для каждого URL и региона появилась пара «код для браузера / код для робота». Расхождение между ними — самостоятельный сигнал, который SEO-команда теперь смотрит раньше позиций: он появляется в день релиза, а просадка в выдаче — через несколько дней.
Что показывают мировые кейсы: региональные и «только для робота» сбои
Ситуация «для людей работает, для робота нет» и «в одном регионе 200, в другом ошибка» задокументирована многократно. Ниже пять инцидентов с публичными постмортемами или разборами в отраслевой прессе, каждый — про частичную, а не тотальную недоступность.
| Дата | Инцидент | Кого задело | Последствия для поиска и бизнеса |
|---|---|---|---|
| 8–12 ноября 2021 | SiteGround: сетевая проблема между AWS Global Accelerator и сетью Google | Около 2 млн доменов недоступны только для Googlebot; пользователи видели сайты нормально | 4–5 дней; страницы и товары выпадали из выдачи и Google Shopping; у одного издателя из Shopping ушло 68 % каталога, другой оценил потери в 20 000+ фунтов |
| 21 июня 2022 | Cloudflare: ошибка в порядке правил BGP отозвала префиксы в 19 дата-центрах | 4 % сети, но около 50 % запросов: Лондон, Франкфурт, Токио, Сан-Паулу и другие; остальные ~250 городов работали | 75 минут недоступности для тех, кого anycast вёл в эти 19 точек; для остальных сайт был жив |
| 8–9 июля 2023 | Verisign: узел резолвинга .com/.net в Сингапуре отдавал просроченные DNSSEC-подписи | Только Азиатско-Тихоокеанский регион; серверы в других локациях отвечали корректно | Около 10 часов ошибок резолвинга .com-доменов в APAC; фикс — увести трафик в США |
| 9 октября 2025 | Azure Front Door: сбой edge-узлов | В основном клиенты вне США — EMEA и Азия; американские пользователи почти не заметили | Около 5,5 часов деградации, разная по регионам |
| 6–12 августа 2026 | Cloudflare Bot Fight Mode отдавал Googlebot challenge-страницу с noindex | Один небольшой сайт; для людей он открывался | Показы в день 1 153 → 16, средняя позиция 10,8 → 67,9 за шесть дней |
Отдельно стоит вспомнить 8 июня 2021 года: из-за бага, который активировала конфигурация одного клиента, Fastly 49 минут отдавала 503 на 85 % своей сети — легли Amazon, Reddit, BBC, gov.uk. Пресса со ссылкой на расчёты SEO-агентства оценивала недополученную выручку Amazon в 32 млн долларов; цифра оценочная, но порядок показателен. И это был глобальный сбой, который заметили все. Региональный сбой опаснее тем, что его не замечает никто, кроме аудитории региона и робота.
Про цену вопроса в целом: по данным Uptime Institute за 2025 год, у 54 % операторов последний серьёзный сбой стоил дороже 100 000 долларов, у каждого пятого — дороже миллиона. Для контентного сайта с органикой как основным каналом потеря — это не минуты простоя, а недели восстановления позиций после того, как сам сбой давно закончился.
Почему в Рунете региональных расхождений стало больше
К механике CDN в России добавился второй слой — фильтрация на уровне операторов, которая тоже региональна и неоднородна. В июне 2026 года клиенты Beget, Timeweb, Selectel, Reg.ru и других хостингов массово столкнулись с тем, что сайты не открывались по HTTP и HTTPS у абонентов одних операторов и нормально работали у других; сами хостинги связывали это с обновлением сигнатур ТСПУ, инфраструктура при этом работала штатно. С июня 2025 года крупные операторы ограничивают трафик через Cloudflare примерно 16 килобайтами на соединение — и делают это каждый по-своему. По подсчётам проекта «На связи», в 2025 году мобильный интернет в регионах отключали больше 11 900 раз, в отдельные месяцы — в десятках регионов одновременно.
Для владельца сайта из этого следует простой вывод: «у меня открывается» больше не означает «открывается у клиентов». Одна проба из одной сети говорит только об этой сети. Проверка из Москвы, Новосибирска и Владивостока через разных операторов — минимальный набор, чтобы отличить проблему сайта от проблемы региона, а региональную 404 CDN — от регионального замедления оператора.
Как настроить мониторинг и деплой, чтобы ловить региональные 404
После разбора клиент изменил и мониторинг, и регламент обновления контента. Эти шаги подходят любому сайту, который раздаётся через CDN и живёт на органическом трафике.
- Поставьте на HTTP-проверку не главную страницу, а список страниц, которые приносят трафик: категории, информационные материалы, посадочные. Для 500 000 URL достаточно выборки в несколько тысяч по всем разделам.
- Включите все точки мониторинга, а не «ближайшую к серверу». Проверка должна идти оттуда, где сидит аудитория и откуда приходят роботы, иначе вы измеряете здоровье одного узла CDN.
- Задайте ожидаемый код 200 и смотрите на код, а не на факт соединения: региональная 404 — это успешное соединение с неправильным ответом. Разбор кодов — в справке по кодам ответа HTTP.
- Продублируйте проверки трафиковых страниц с User-Agent YandexBot и Googlebot: расхождение кода между «браузерной» и «роботной» проверкой — сигнал о том, что WAF, кэш или рендер отдают роботу другой ответ.
- Для SEO-критичных страниц снизьте порог инцидента: если ошибку видит треть точек, это уже повод разбираться, потому что робот может быть среди этой трети. Для остальных страниц оставьте порог по умолчанию, чтобы не тонуть в шуме.
- Раз в неделю просматривайте «запуски с частичным сбоем» и матрицу по локациям: серия частичных сбоев на одной группе URL — ранний признак проблемы с CDN, даже если ни один инцидент не открылся.
- Забирайте результаты проверок по API в свою аналитику и кладите рядом с позициями и трафиком: корреляция «404 в регионе → выпадение из топ-10» видна только там, где обе метрики лежат в одной таблице.
- Сверяйте эпизоды из мониторинга с логами origin по User-Agent роботов: если робот получал 404 в окне, которого нет в логах origin, ответ отдал кэш CDN.
Со стороны инфраструктуры клиент запретил кэшировать ошибки на прокси-слое перед CDN и добавил в регламент обновлений принудительную очистку кэша по затронутым URL с контрольной проверкой из регионов после purge. В терминах nginx это выглядит так:
# кэшируем только успешные ответы и редиректы;
# 404 и 5xx в списке нет - они не попадут в кэш
proxy_cache_valid 200 301 302 10m;

# на время плановых работ отдавать 503, а не 404:
# для поисковиков 503 - "зайди позже", 404 - "страницы нет"
error_page 503 /maintenance.html;
add_header Retry-After 3600 always;
Правило «503 вместо 404 на время работ» — рекомендация самого Google: в документации о приостановке бизнеса прямо сказано не отвечать 403, 404 или 410, потому что это удалит URL из выдачи, а 503 с Retry-After робот будет перепроверять около недели. Яндекс, по собственной справке, заголовок Retry-After не учитывает, но 503 тоже трактует как временную недоступность.
Проверить, кому именно из роботов доставались ошибки, помогает одна команда по access-логу origin (на CDN-логах она же покажет узел, отдавший ответ):
# сколько 404 получили роботы за сутки, по User-Agent
grep -E "YandexBot|Googlebot" access.log \
  | awk '$9 == 404 {print $14}' | sort | uniq -c
# пример вывода
    312 "Mozilla/5.0 (compatible; YandexBot/3.0; ...)"
     87 "Mozilla/5.0 (compatible; Googlebot/2.1; ...)"
Пруфен проверяет доступность страницы из 20 точек мониторинга — 17 в России, а также Минск, Астана и Испания — с интервалом от 2 минут, а вкладка «По локациям» показывает код ответа каждой точки на каждом запуске, включая частичные сбои, не дошедшие до порога инцидента. HTTP-проверку можно запускать с User-Agent YandexBot или Googlebot, чтобы видеть страницу так, как её видит робот. Все результаты по каждой точке доступны через REST API, так что их можно забирать в свою аналитику. Порог открытия и закрытия инцидента настраивается отдельно, уведомления приходят на Email, в Telegram и Макс; если ресурс так и не поднялся, подключается голосовой звонок. Бесплатный план — 5 проверок, при регистрации на счёт начисляется 150 ₽. Поставить трафиковые страницы на мониторинг из регионов.
Частые вопросы
Почему инцидент не открылся, если 8 точек из 14 видели 404? Потому что порог инцидента по умолчанию — 80 % точек: он защищает от ложных тревог, когда одна-две точки споткнулись о сеть. Но частичные сбои не пропадают: они записываются в матрицу и в счётчик «запусков с частичным сбоем». Для страниц, где важна каждая точка, порог можно снизить в настройках проверки.
Почему инженеры не видели 404 в логах сервера? Потому что ответ отдавал кэш узла CDN, а не origin. Запрос робота до сервера не доходил, поэтому в access-логе origin его нет. Искать нужно в логах CDN — там будет и узел, и признак попадания в кэш, и возраст ответа.
Чем региональная 404 хуже регионального 500? Поисковики трактуют 5xx как временную проблему: Google замедляет обход и сохраняет URL в индексе несколько дней, 503 перепроверяет около недели. Ответ 404 они читают как «страницы больше нет» и начинают удалять URL уже через пару дней. Поэтому при любых работах правильный код — 503 с Retry-After, а не 404.
Достаточно ли проверять сайт из двух-трёх городов? Лучше, чем из одного, но узлов у CDN десятки, а операторы фильтруют трафик каждый по-своему. Чем больше точек в разных сетях и регионах, тем выше шанс попасть на тот же узел, что и робот или аудитория конкретного региона. В кейсе ошибка в разные эпизоды приходилась на разные наборы городов — от трёх до почти всех.
Можно ли получить результаты по каждой локации, а не только факт инцидента? Да. В API Пруфена история результатов проверки отдаётся с идентификатором локации, кодом ответа, флагом успеха и разбивкой времени ответа по фазам — DNS, TCP, TLS, обработка на сервере, загрузка. Именно из этих строк клиент собрал витрину «дата × URL × регион × код» для своего SEO-дашборда.
Зачем проверять страницу от имени робота, если она открывается в браузере? Потому что сайт часто отвечает роботу не тем, чем браузеру: антибот-правила WAF срабатывают на строку «bot» в User-Agent, кэш может хранить отдельный вариант страницы для роботов, серверный рендеринг включается только для поисковиков. В Пруфене у HTTP-проверки есть пресеты User-Agent YandexBot и Googlebot; это имитация только строки UA, не IP-адреса, но именно на UA завязано большинство таких правил.
Как быстро страницы вернулись в топ после исправления? Не сразу и не синхронно: по справке Яндекса возврат страницы в поиск после исправления занимает до трёх недель, Google называет «неделю-две». Часть страниц вернулась на прежние позиции, часть — ниже: за время отсутствия место в выдаче заняли конкуренты. Поэтому дешевле поймать 404 в первые 15 минут по мониторингу, чем возвращать позиции неделями.