Инцидент-менеджмент для сайта: MTTD, MTTR, постмортем и дежурства без бюрократии
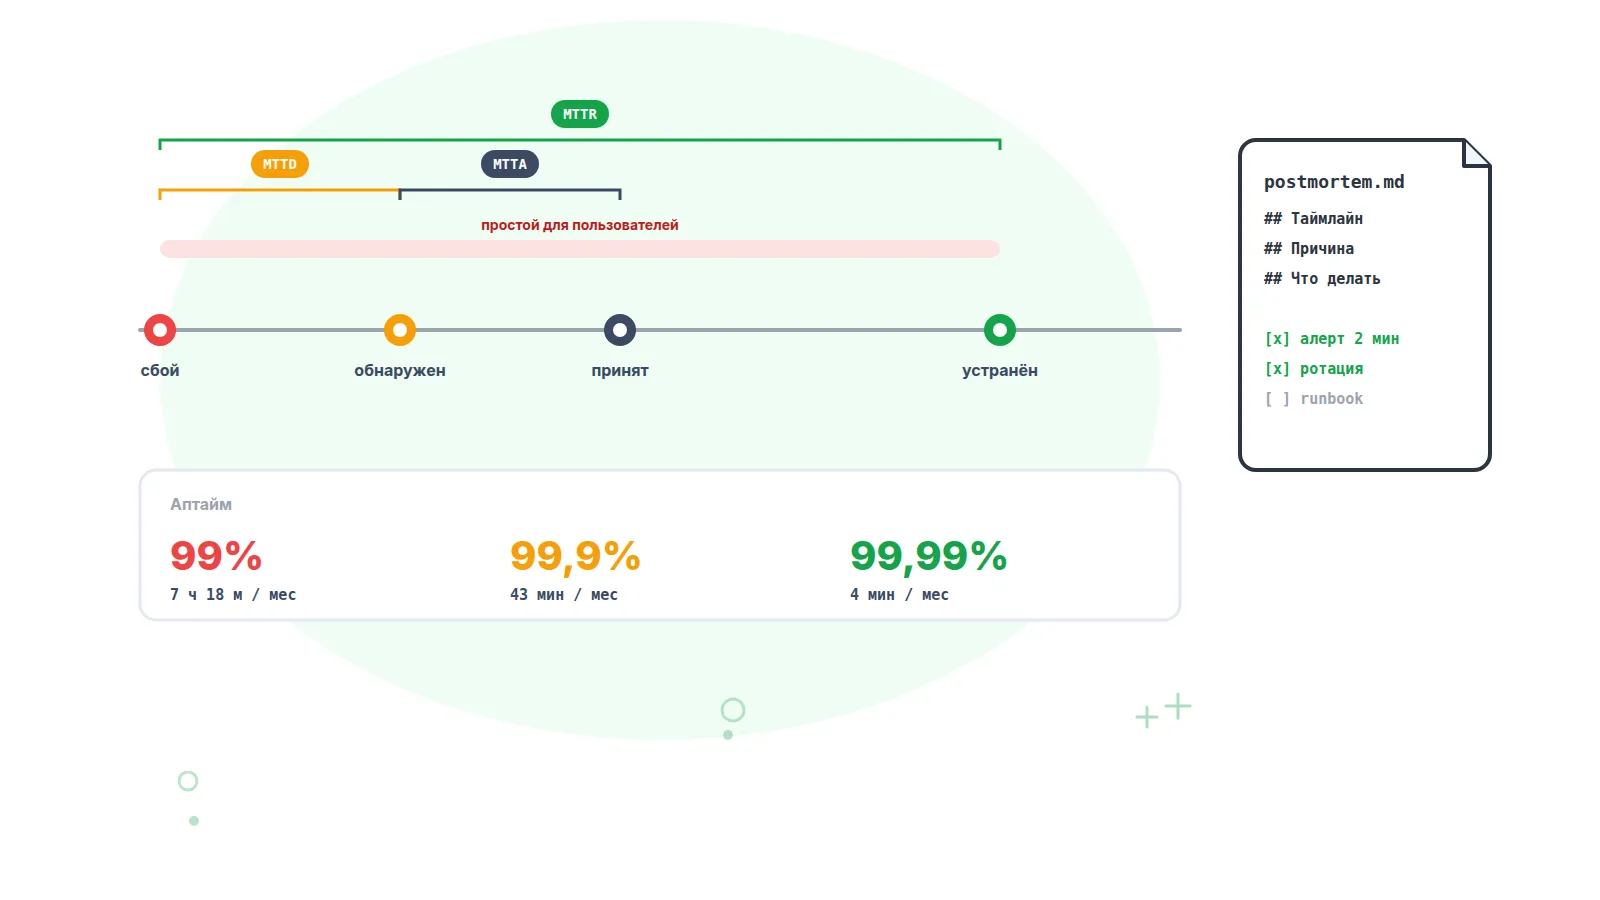
Процесс инцидент-менеджмента для команды из трёх человек: метрики MTTD/MTTA/MTTR с расчётом, уровни SEV, дежурства и шаблон постмортема в одну страницу.

Всё о том, как узнавать о падении сайта раньше клиентов: как устроен мониторинг доступности, какой интервал проверки выбрать, как считать аптайм и SLA, куда слать уведомления и как не утонуть в ложных срабатываниях.
Начните со статьи «Что такое мониторинг сайта и зачем он нужен», а если сайт уже упал — откройте план действий на первые 10 минут.
35 статей
Процесс инцидент-менеджмента для команды из трёх человек: метрики MTTD/MTTA/MTTR с расчётом, уровни SEV, дежурства и шаблон постмортема в одну страницу.
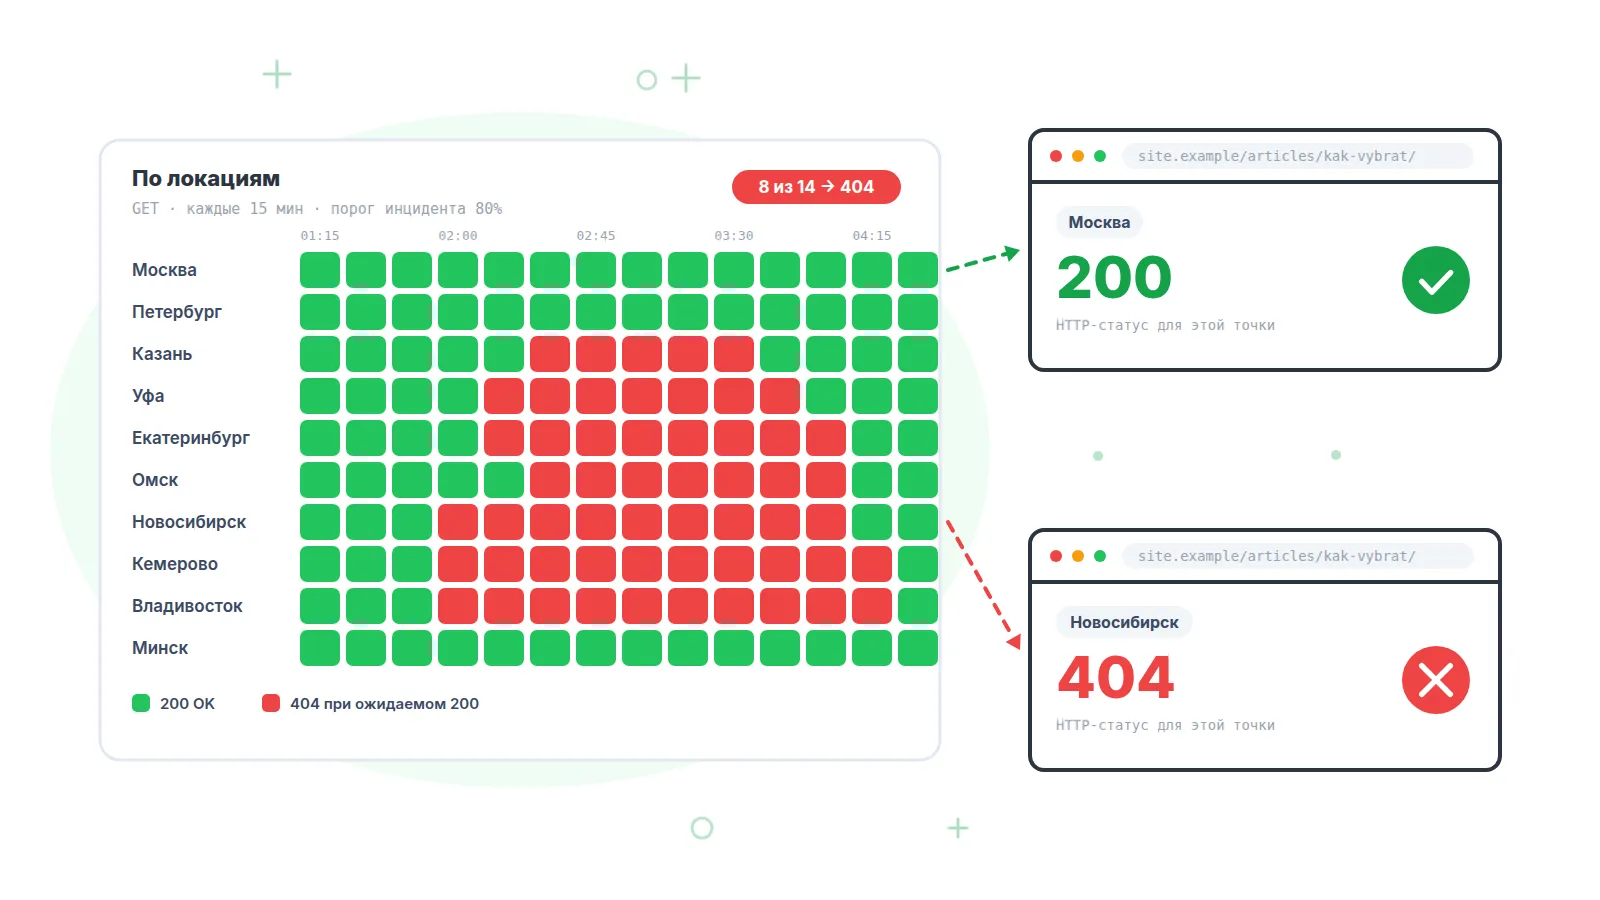
Портал с 500 000+ страниц: региональные 404 на узлах CDN, которых не видно из Москвы, выбивали страницы из топ-10. Как нашли, почему так и что менять.
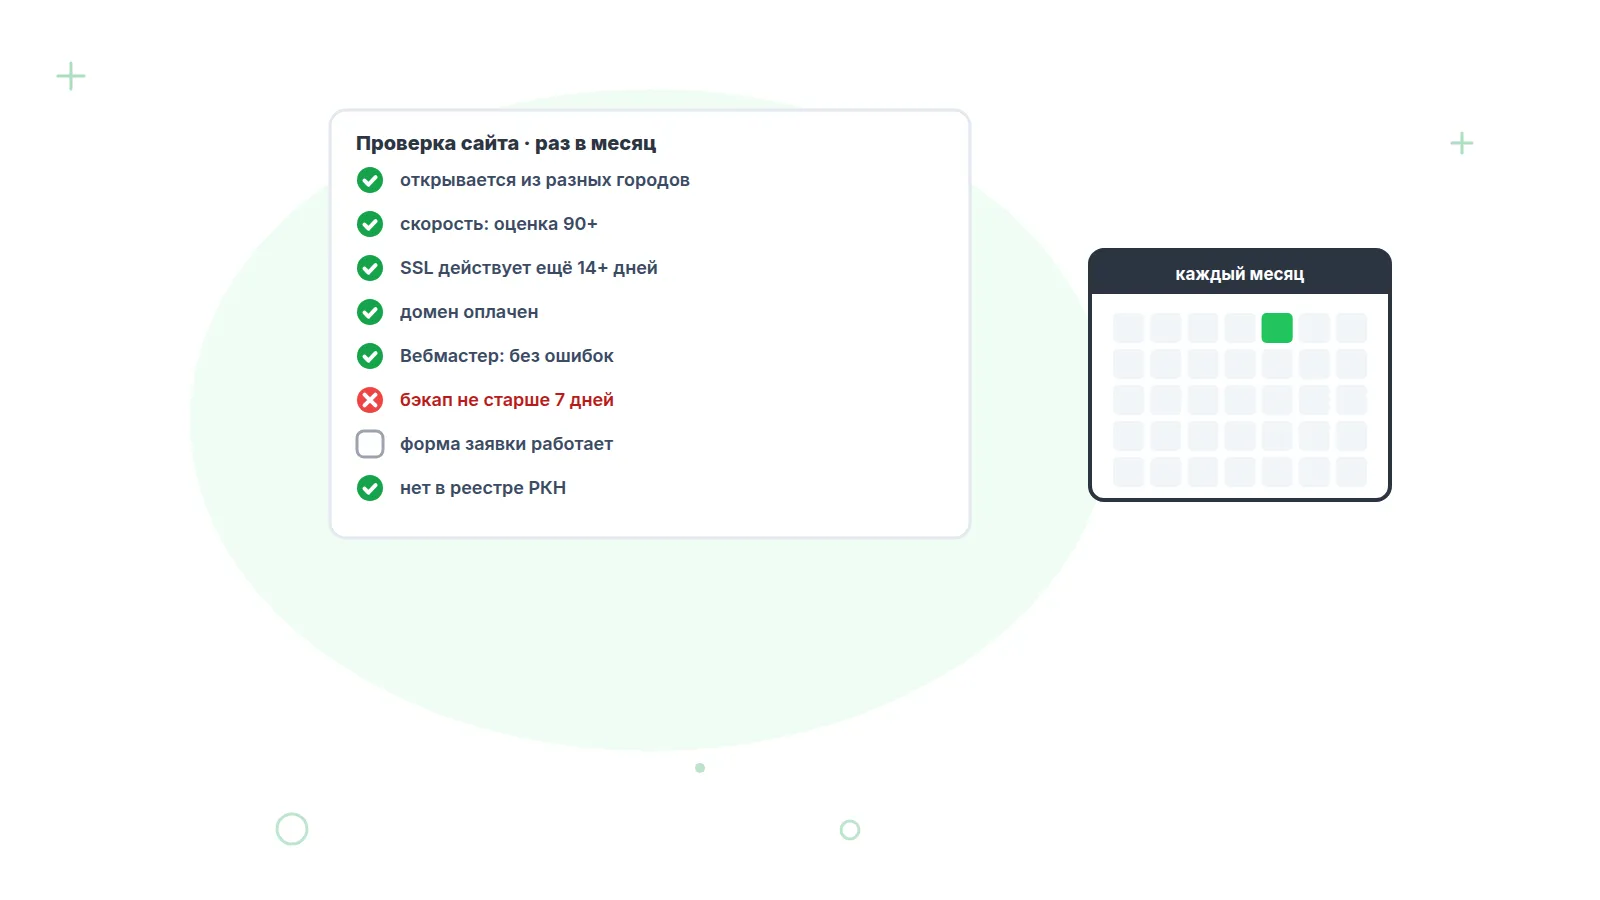
Хаб-инструкция для владельца сайта: 12 проверок в одной таблице «что → зачем → чем бесплатно → норма → как часто», регламент на 30 минут и памятка.
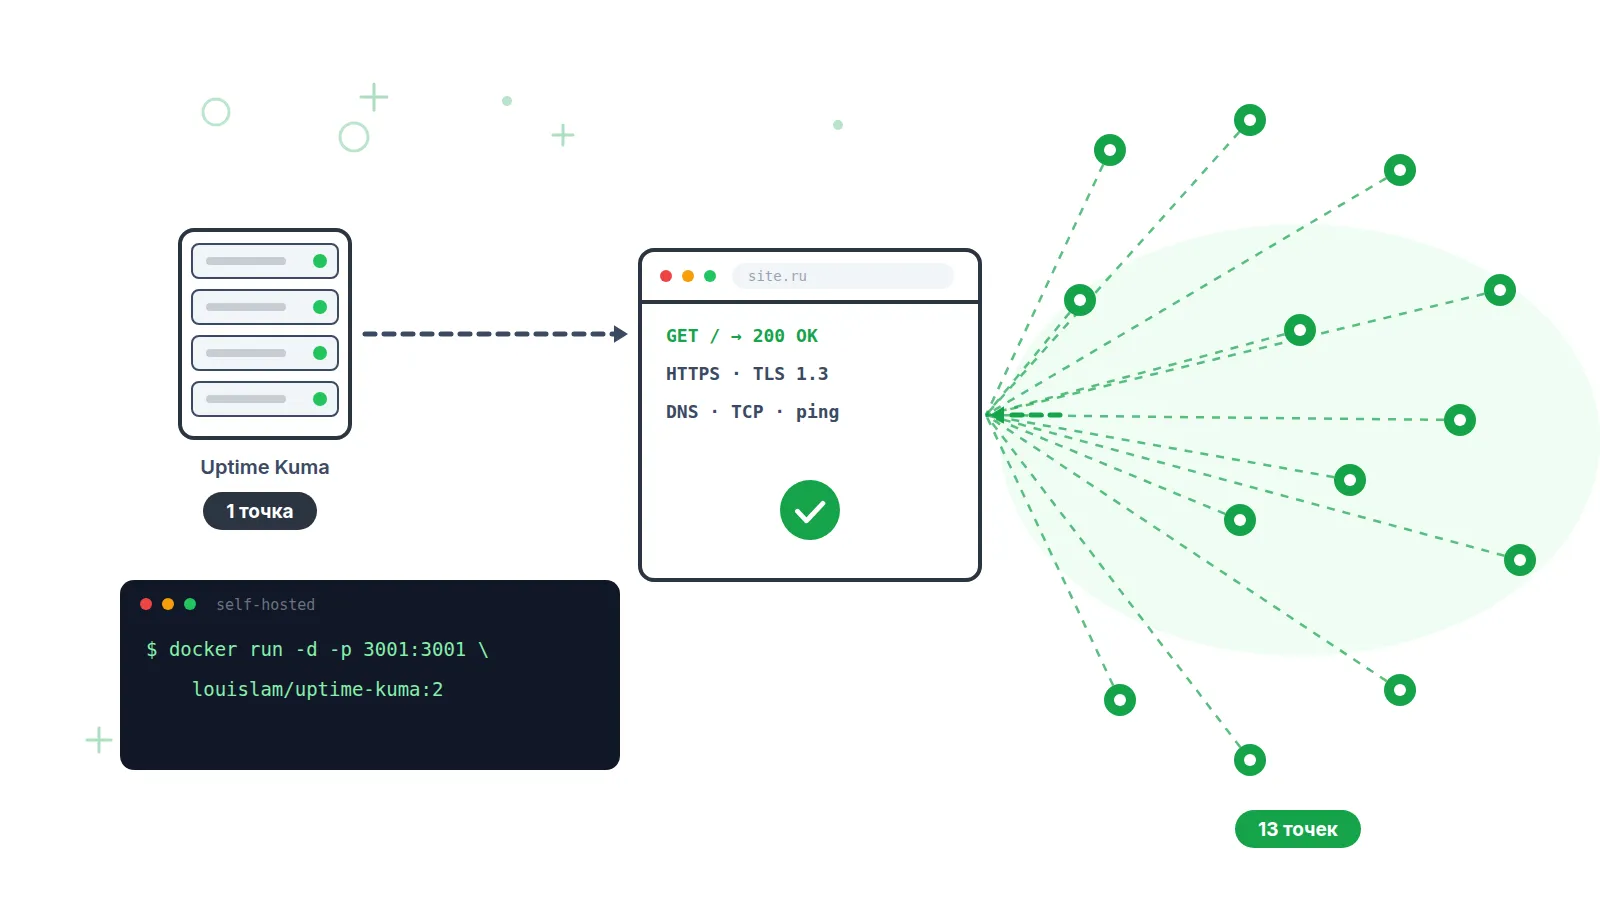
Самый популярный self-hosted мониторинг: что умеет, чего не умеет принципиально, сколько стоит «бесплатно» и в какой схеме работает лучше всего.
География точек, подтверждение падений, каналы уведомлений и журнал инцидентов: восемь вопросов любому сервису мониторинга — включая нас.
Клиенты жалуются, а при проверке всё работает: откуда берутся кратковременные сбои и как поймать их за руку.
Десять привычек, которые сокращают частоту и длительность падений: от бэкапов с проверкой восстановления до плана инцидента.
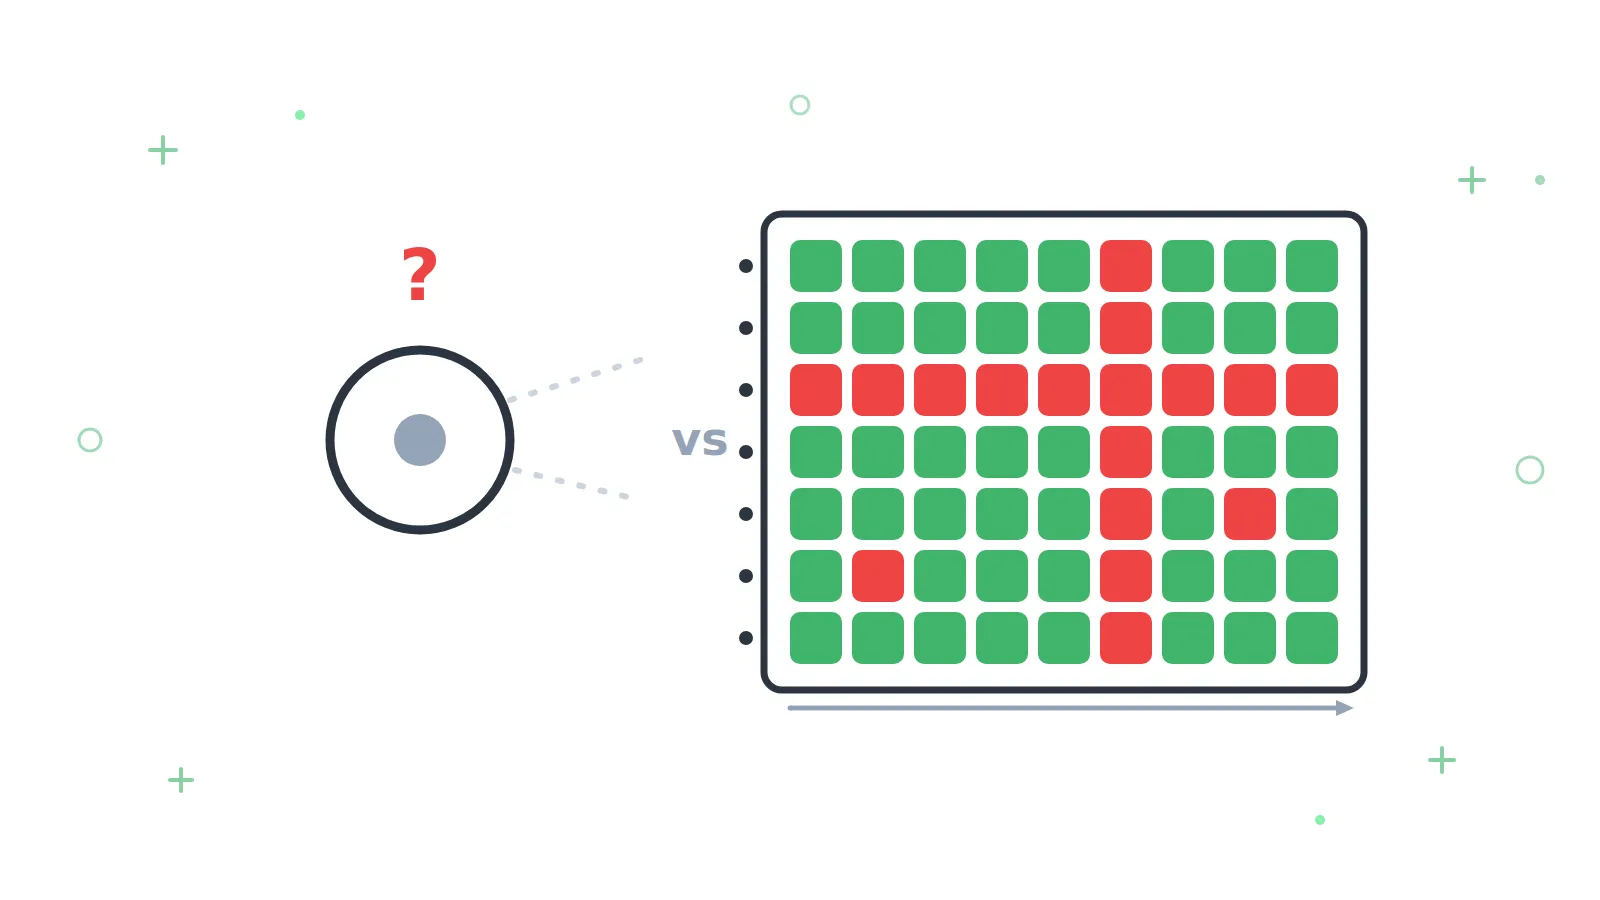
Одна точка мониторинга не видит региональных сбоев, генерирует десятки ложных тревог и не ставит диагноз. Разбор с цифрами и матрицей по локациям.
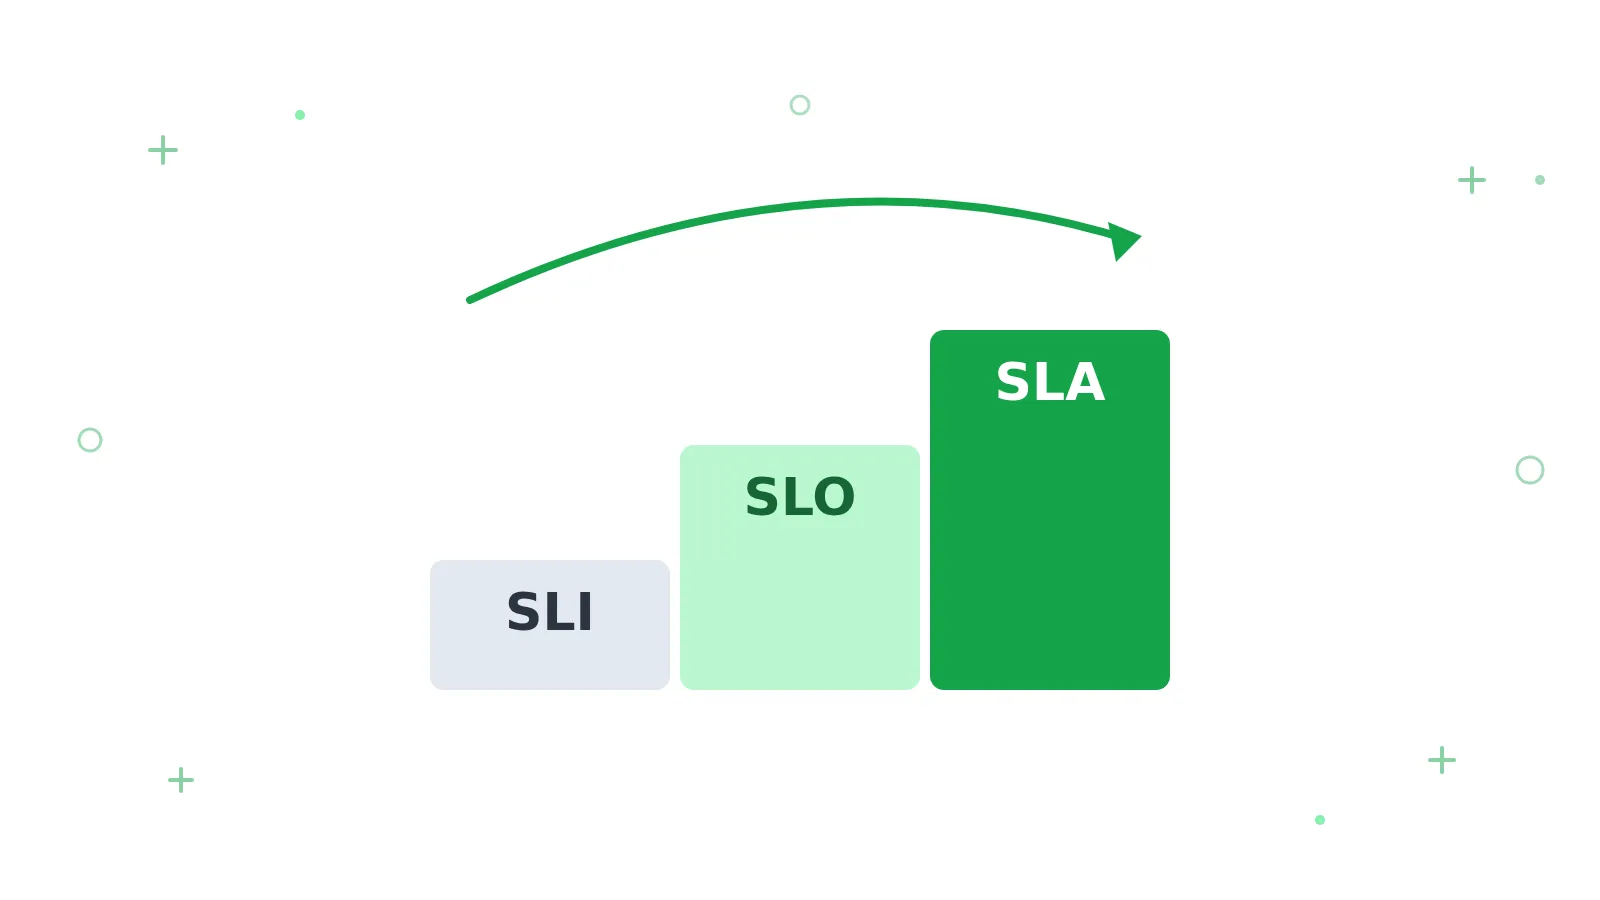
Индикатор, цель и договор: как устроена система SLI/SLO/SLA и как пользоваться ею без SRE-команды.
Интервал проверки — это максимальное время незнания о падении. Как выбрать его под свой сайт и не платить за лишнюю частоту.
Роботы по расписанию или данные реальных посетителей? Разбираем, на какие вопросы отвечает каждый подход и где их слепые зоны.
Регламент владельца при падении: масштаб за 2 минуты, диагноз по виду ошибки, безопасные действия, коммуникация и постмортем.
Что нужно, чтобы Zabbix заработал, что он умеет для сайтов и когда он избыточен. С таблицей сайзинга и честным расчётом стоимости в часах.
Мониторинг прислал «сайт упал», через тридцать секунд — «восстановлен». Разбираем на цифрах, какими настройками лечится этот дребезг.
Пять способов проверить доступность сайта из России — от ping и curl до постоянного мониторинга из 11 городов. С живыми цифрами и командами.
Страница отдавала 200, кнопка была на месте — а нажатие на неё ничего не делало. Три дня никто не понимал, почему перестали приходить заявки.
Переводим девятки в минуты: сколько простоя допускает каждый уровень SLA, что спрятано в исключениях и как проверить обещания фактами.
Для SaaS недоступное приложение или сломанный вход — это все клиенты сразу. Разбираем, что настроить в мониторинге в первую очередь.
Мониторинг может заметить падение сайта за пару минут — и всё равно быть бесполезным, если уведомление уйдёт в канал, который никто не проверяет.
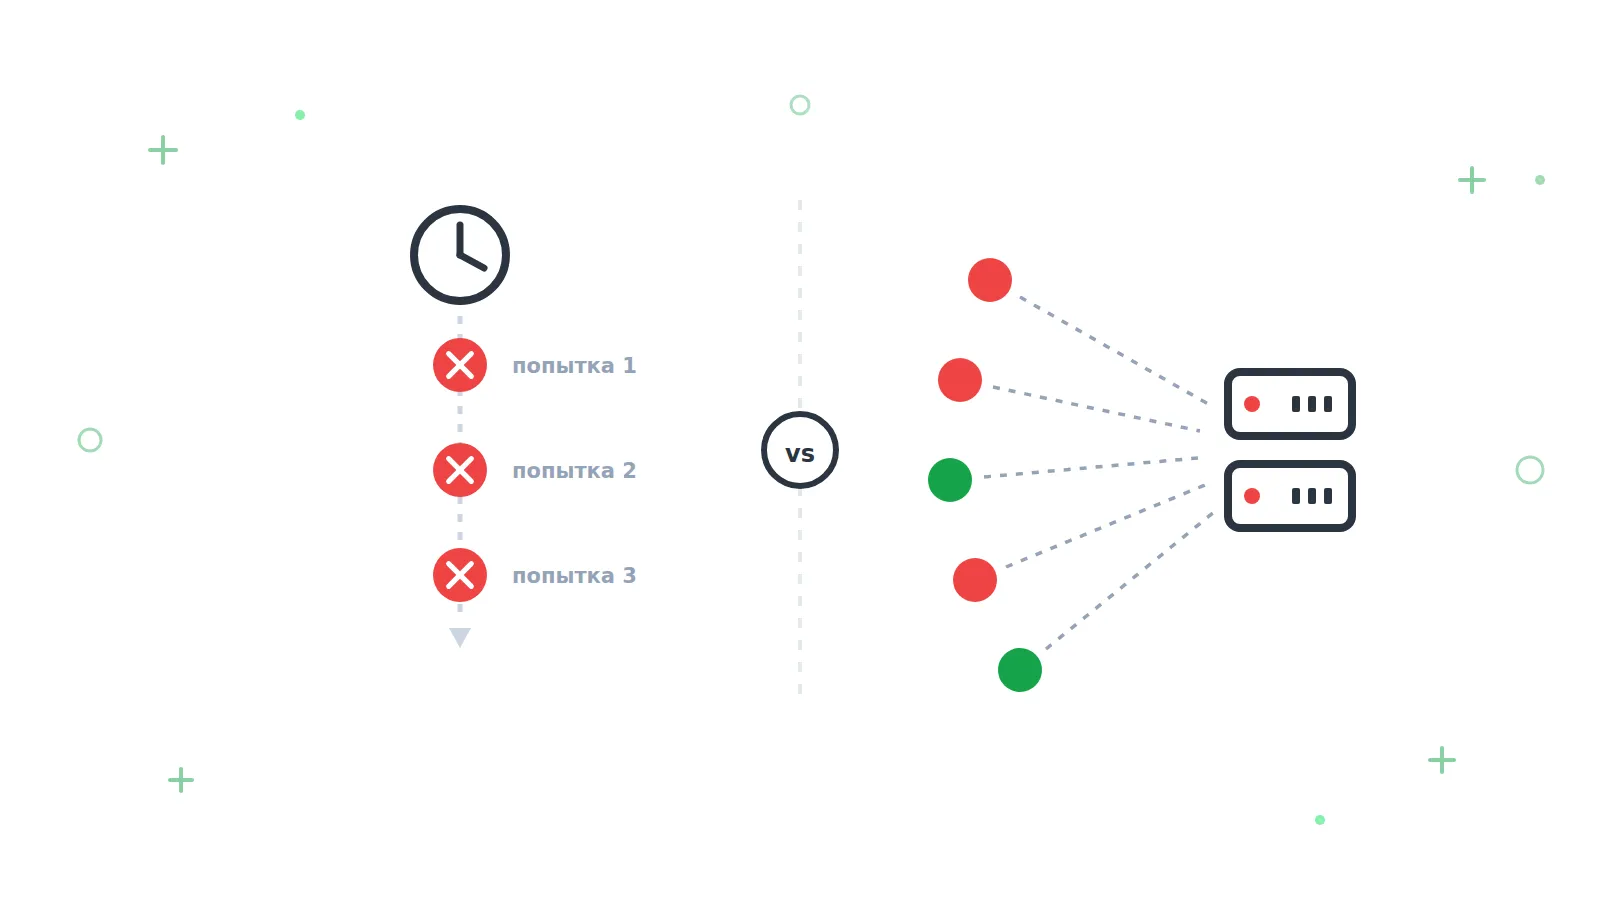
Две архитектуры подтверждения недоступности — кворум по локациям и ретраи во времени. Разбор механик шести сервисов по их публичной документации.
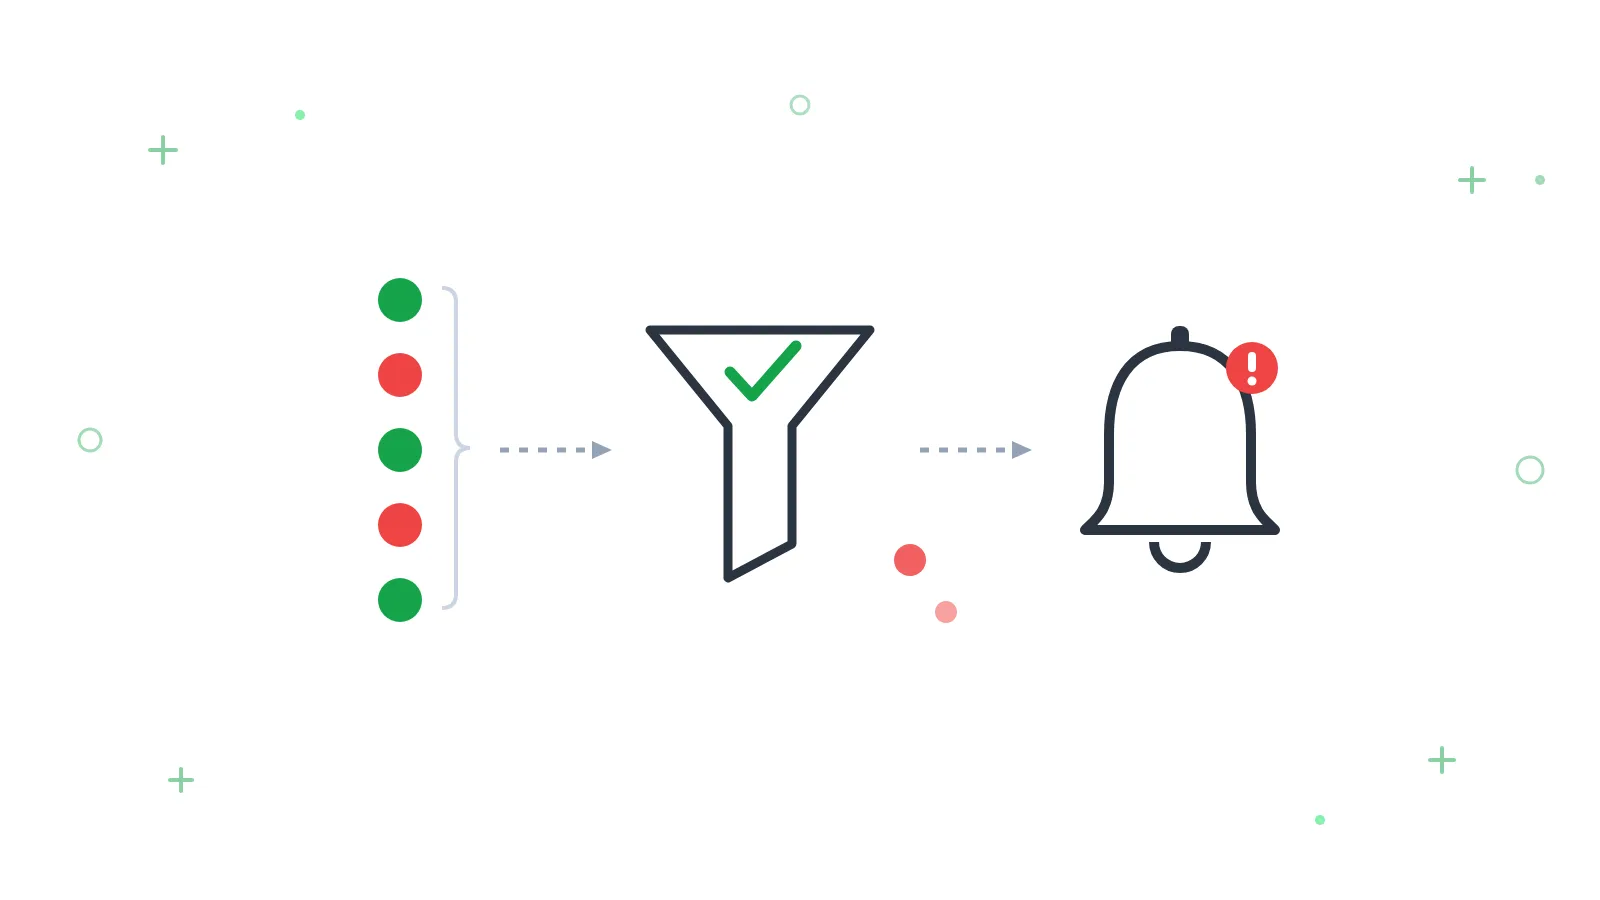
Что происходит между проверкой сайта и сообщением в мессенджере: 13 точек, пороги, задержка уведомлений и закрытие инцидента — по шагам.
WordPress ломается не так, как статичный сайт: чаще всего виноват не хостинг, а собственное обновление — плагин, тема или сама платформа.
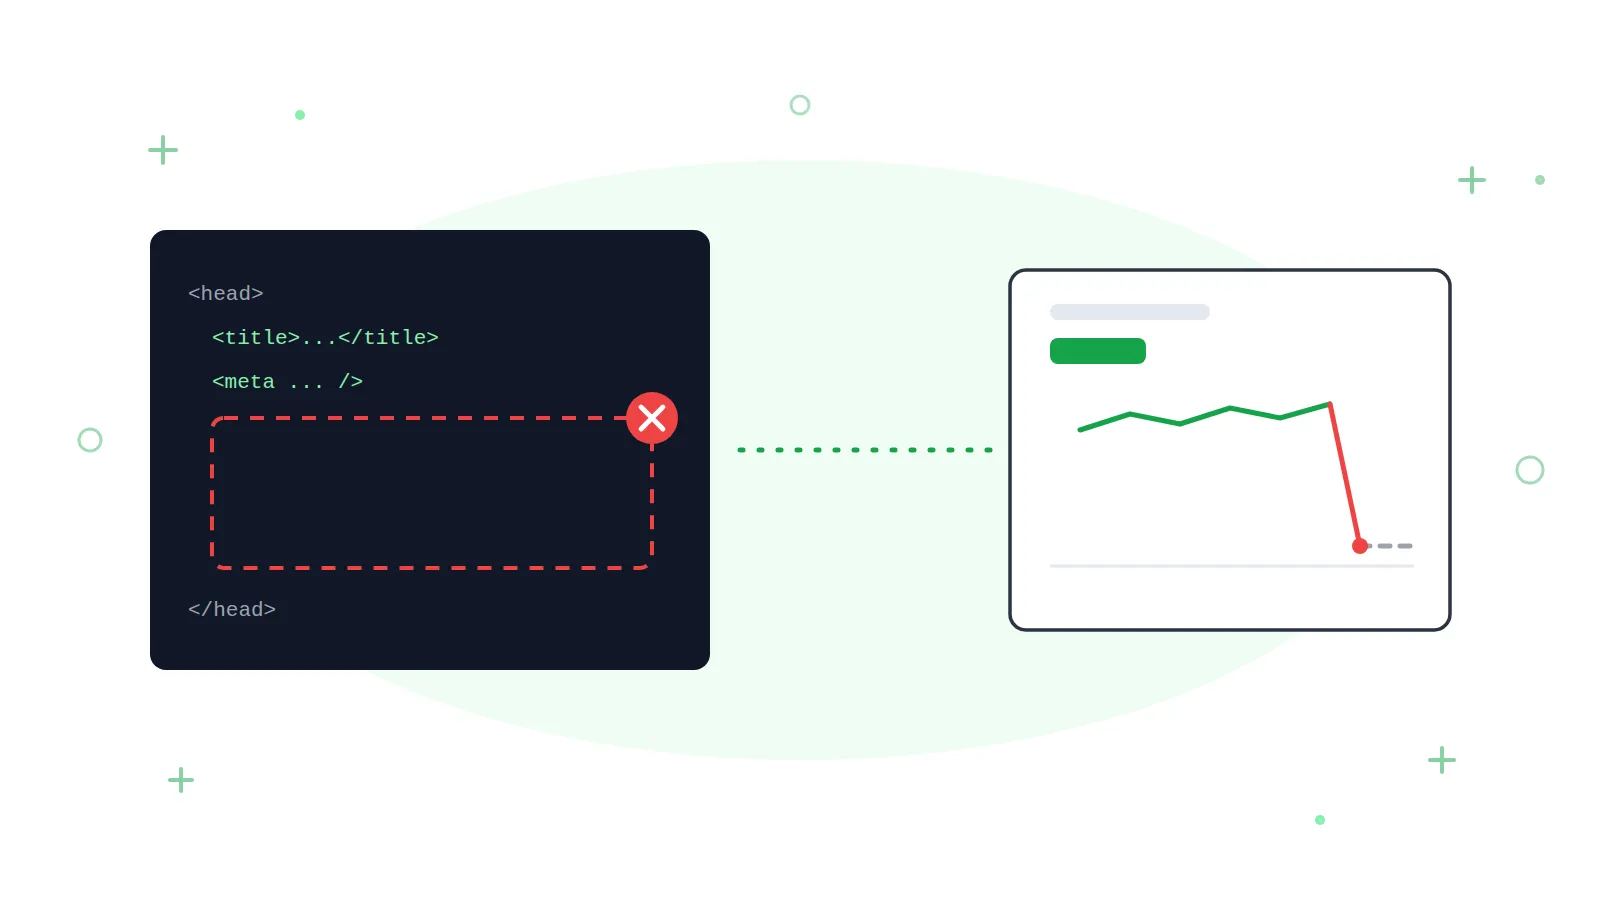
Счётчик аналитики исчезает с части страниц тихо: сайт работает, отчёты открываются, но цифры в них неправильные. Разбираем, как это вовремя заметить.
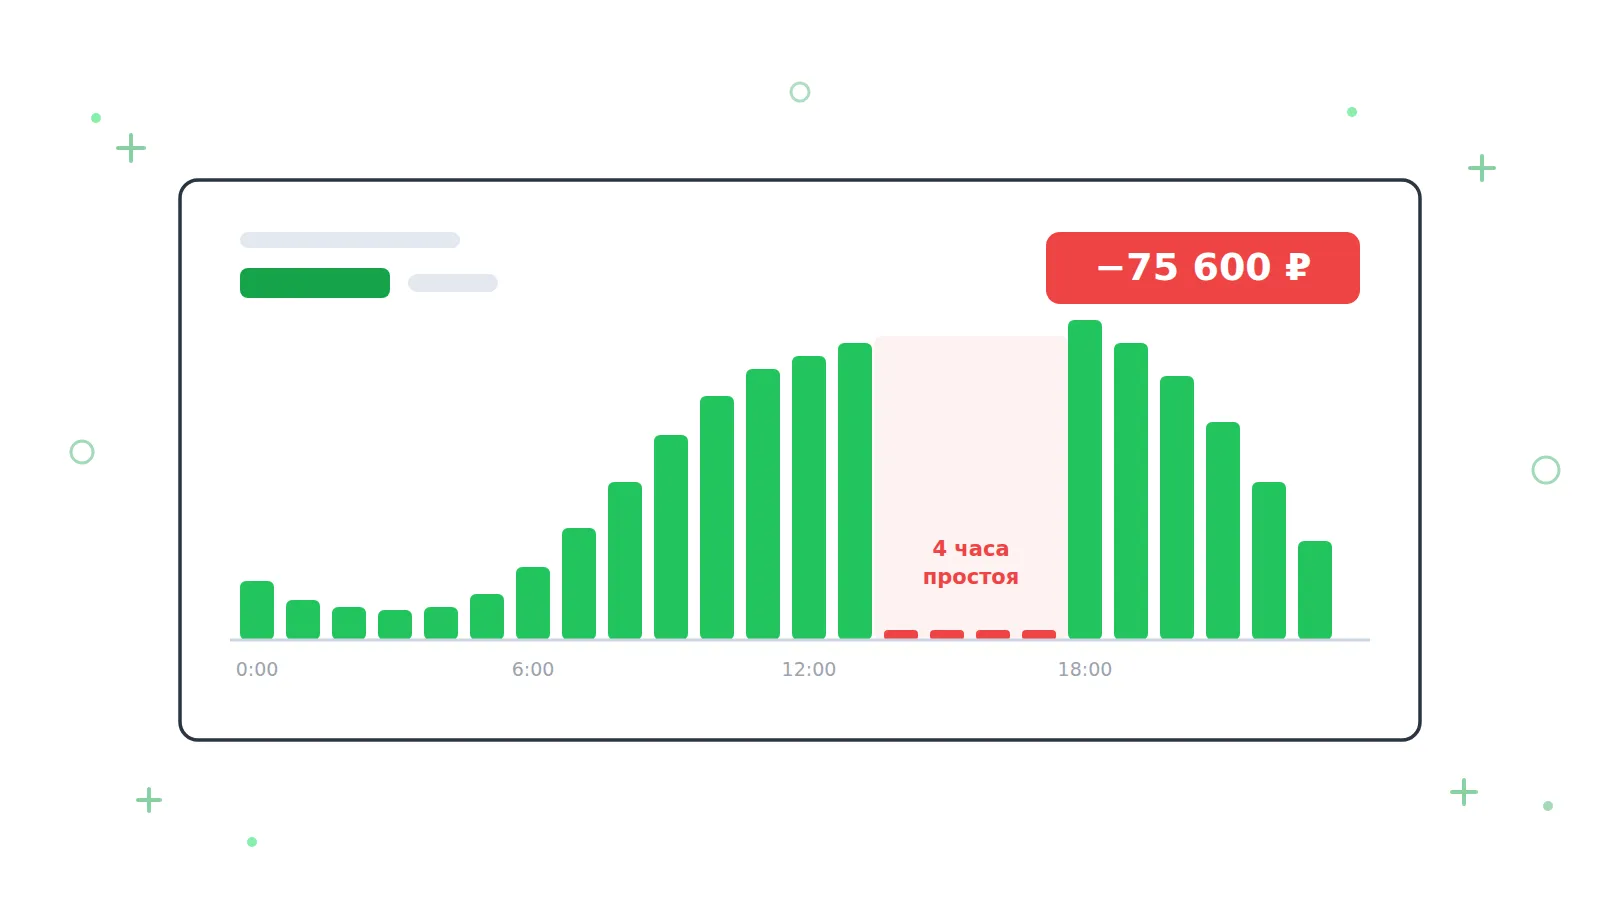
Три аварии с опубликованными суммами убытков, формула потерь и расчёт на модельном интернет-магазине.
Мониторинг, который просто «видит» падение, но не может достучаться до нужного человека вовремя, почти бесполезен. Разбираем настройку уведомлений.
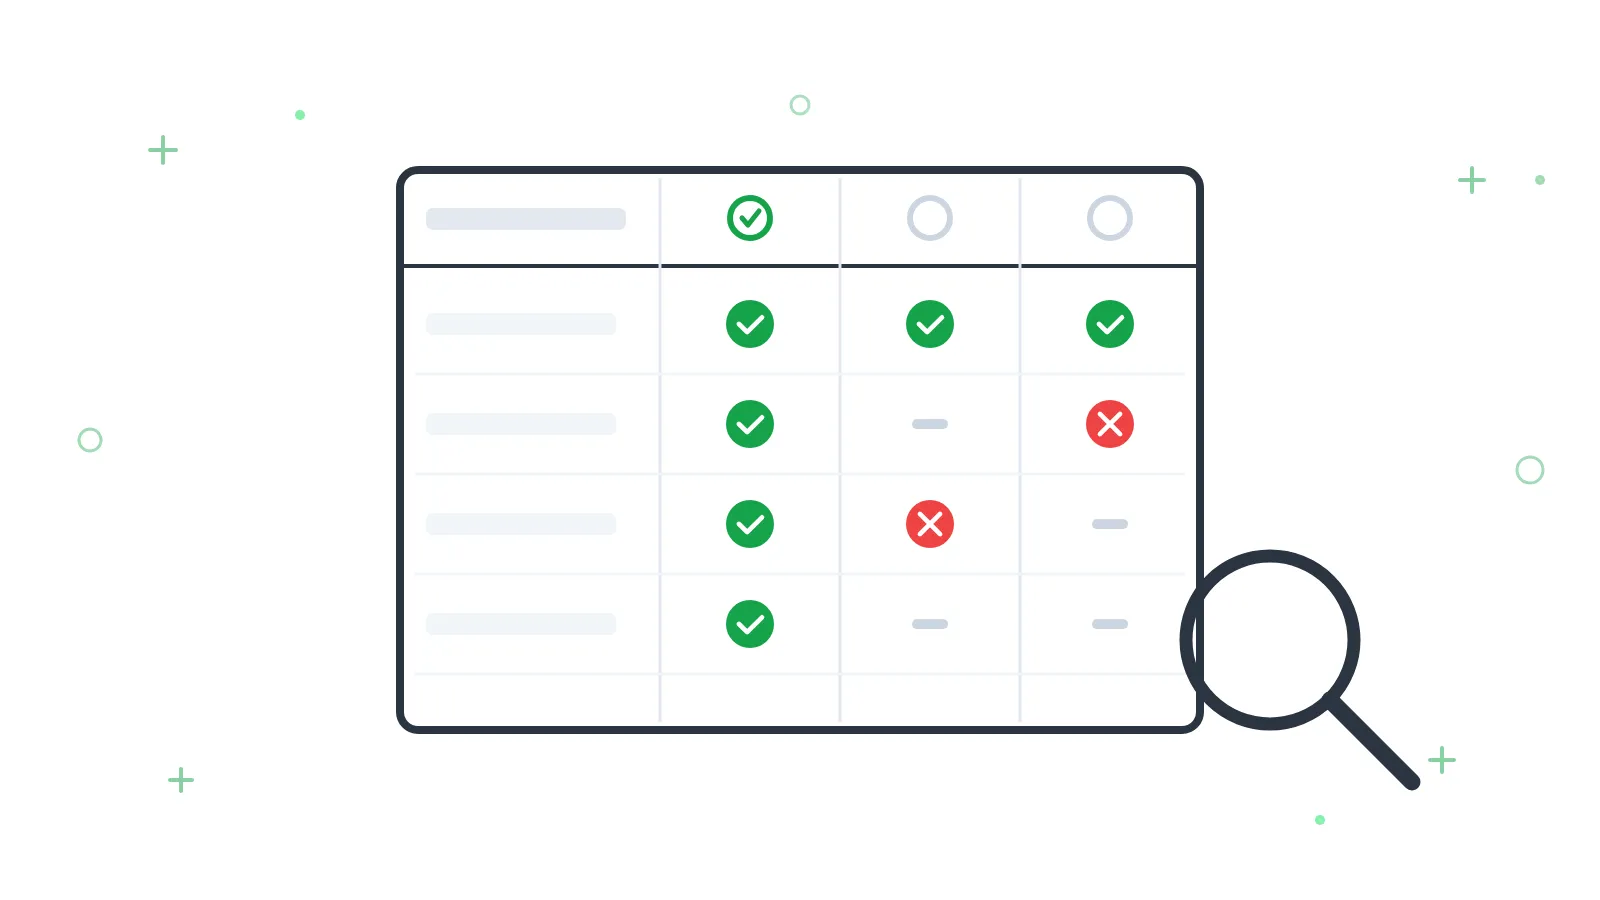
Сравниваем UptimeRobot, Pingdom, Better Stack, Uptime Kuma и Пруфен по возможностям — без цен: точки в России, проверки Рунета, уведомления.
Проверка главной страницы — самая бесполезная из всех, которые обычно настраивают первыми. Разбираем восемь проверок, которые реально нужны магазину.
«У нас аптайм 99,9%» звучит внушительно, пока не посчитать простой в минутах. Разбираем, что такое uptime и как его честно считать.
Клиент или руководитель периодически спрашивает «а сайт вообще сейчас работает?». Решается это проще, чем строить отдельную страницу статуса.
«У меня сайт открывается» — самая ненадёжная диагностика: она проверяет только вашу сеть в моменте. Разбираем, зачем нужны разные точки проверки.
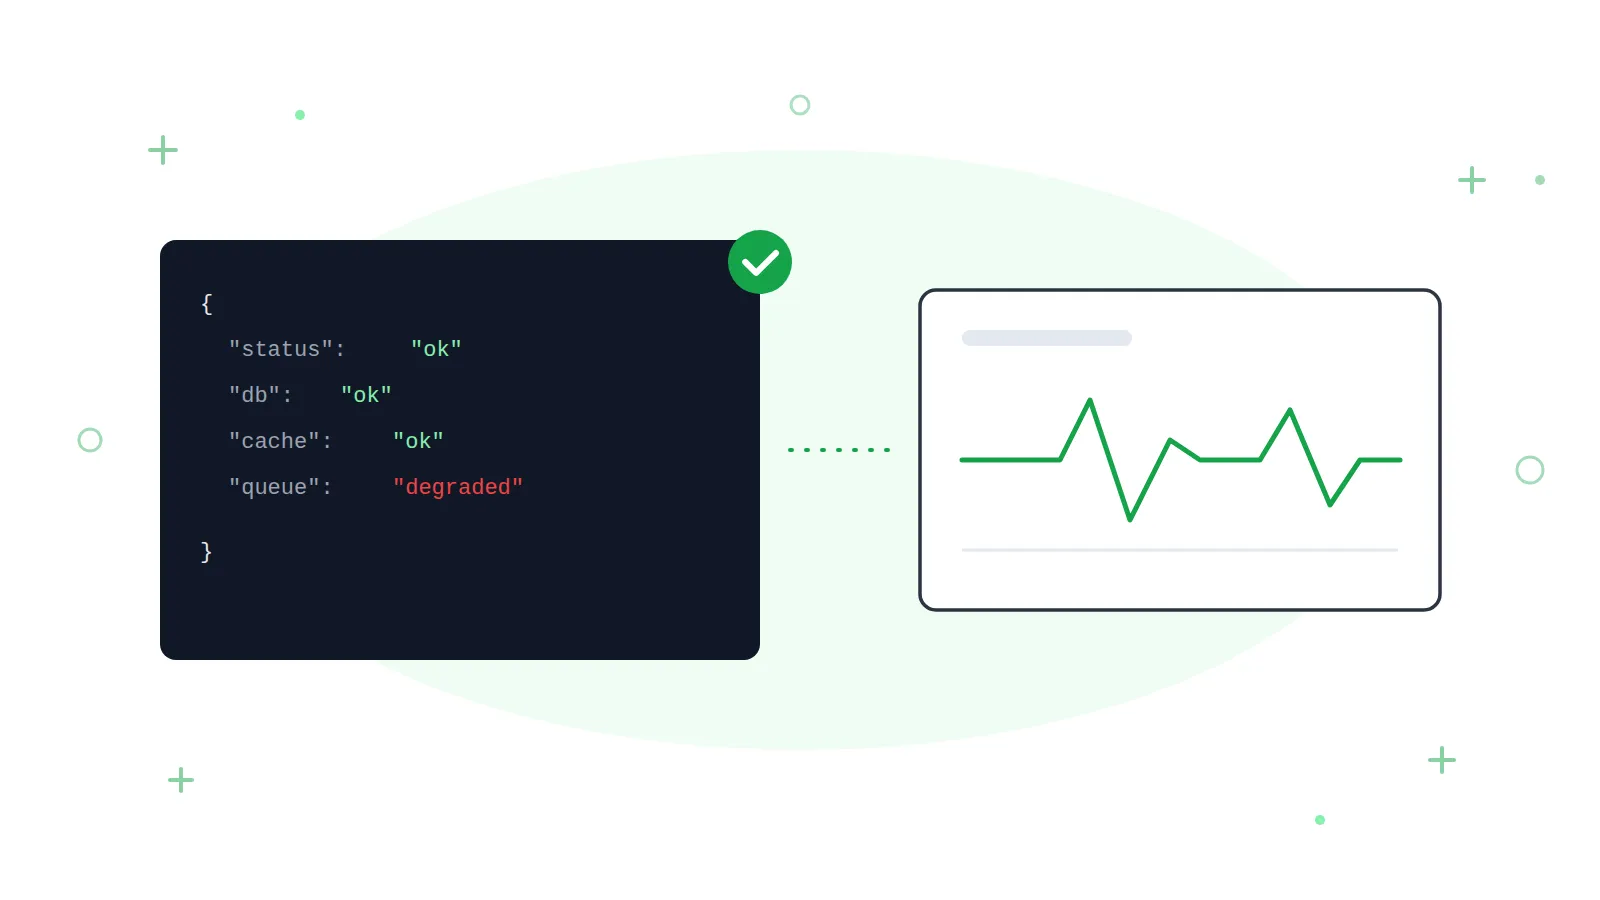
Healthcheck — адрес, по которому сервис отвечает, здоров ли он. Сделанный правильно, он падает раньше, чем это заметят пользователи. Разбираем, как его сделать.
В договоре с хостером написано «гарантированная доступность 99,9%». Но кто и как это вообще проверяет? Разбираем, что такое SLA хостинга на практике.
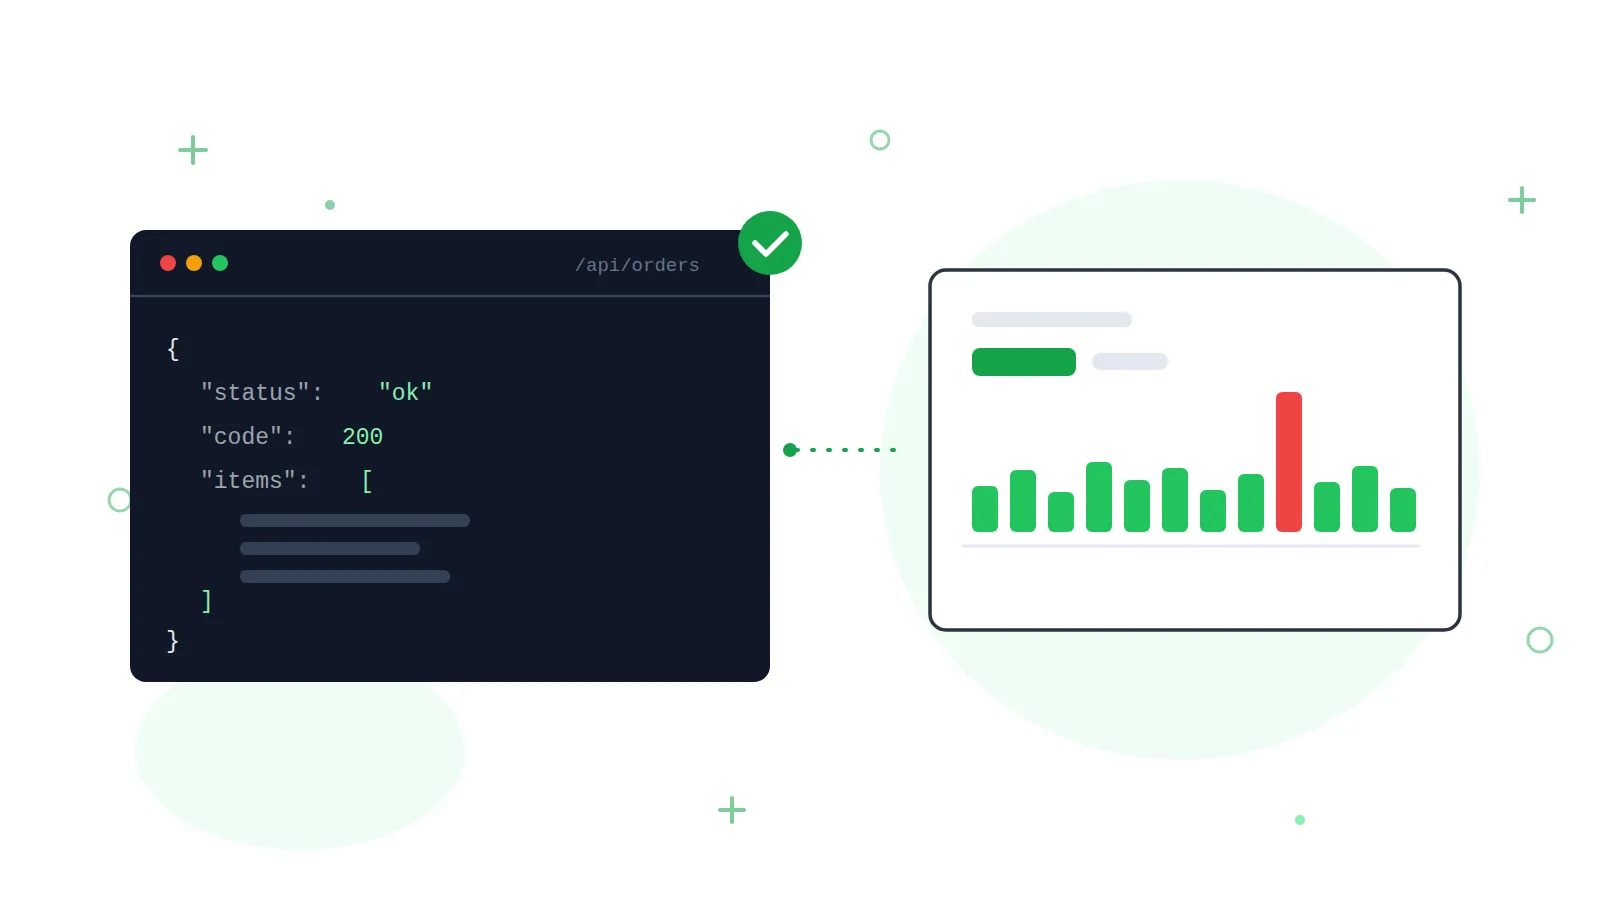
Почему код 200 у API ничего не гарантирует, какие endpoint'ы брать под наблюдение и как не утонуть в ложных тревогах.
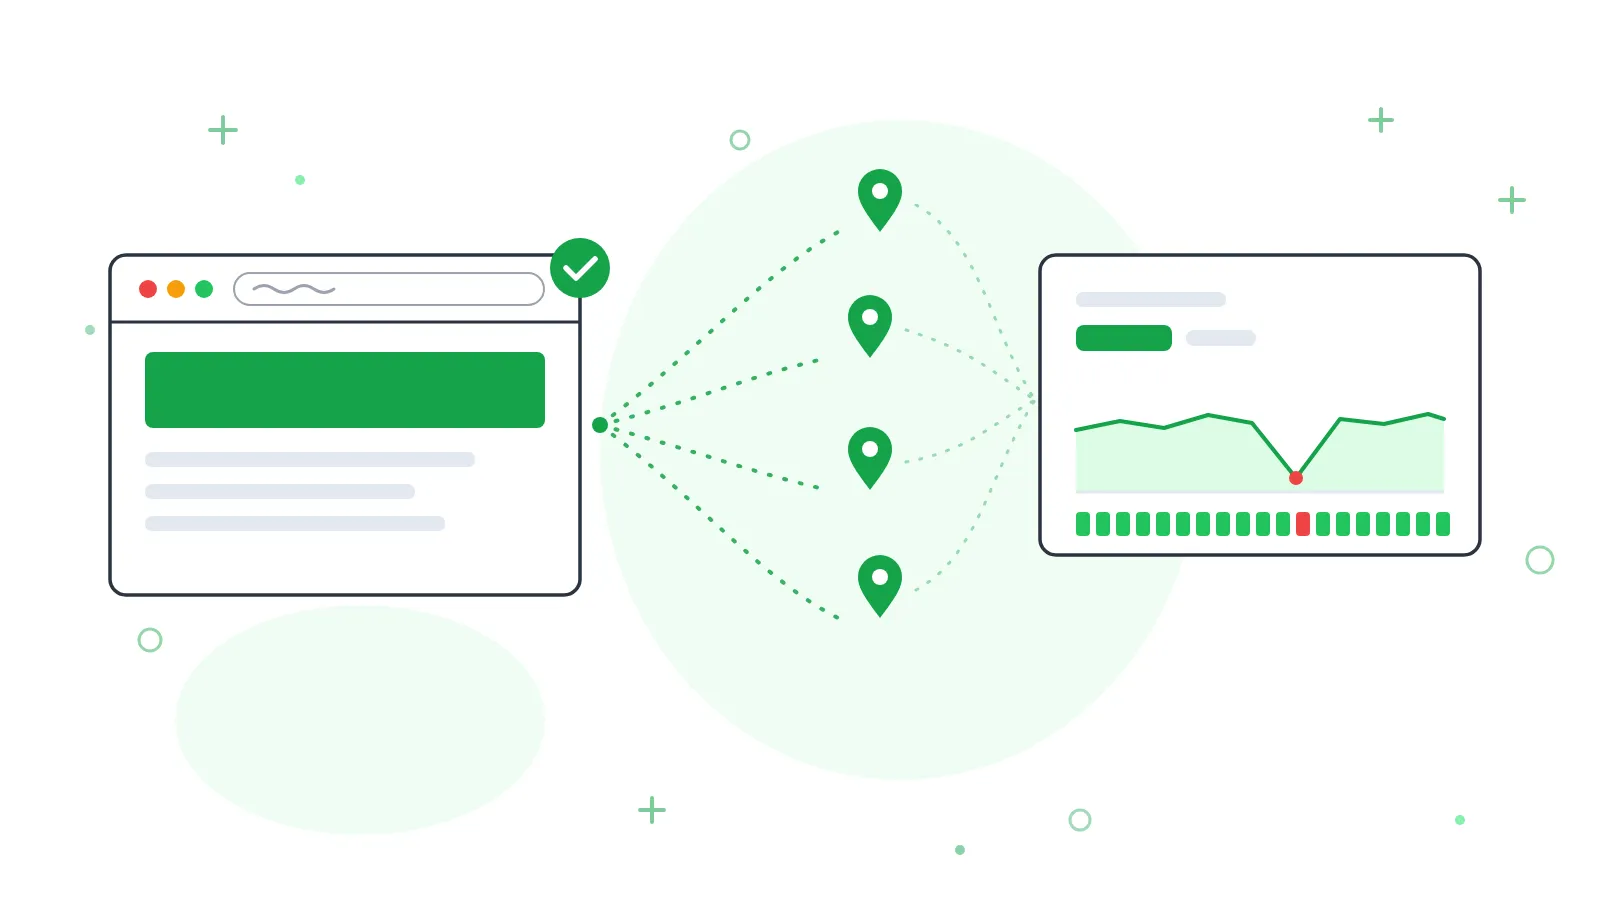
Что такое мониторинг сайта, какие проверки бывают, как читать uptime и настроить всё за 10 минут.
В 2006 году Amazon провёл внутреннее исследование, которое изменило подход к веб-оптимизации на десятилетия вперёд. Инженеры намеренно замедлили загрузку страницы на 100 миллисекунд — одна десятая секунды, практически незаметно для человека.