
 Максим Дорохов
Мониторинг API: как отслеживать доступность endpoint'ов
Мониторинг API — это регулярная проверка того, что программный интерфейс отвечает, отвечает быстро и возвращает корректные данные. У сайта поломку замечает посетитель, у API — соседний сервис, и молча: сломанный endpoint неделями роняет заказы, пока никто не смотрит в логи.
Чем это отличается от мониторинга сайта
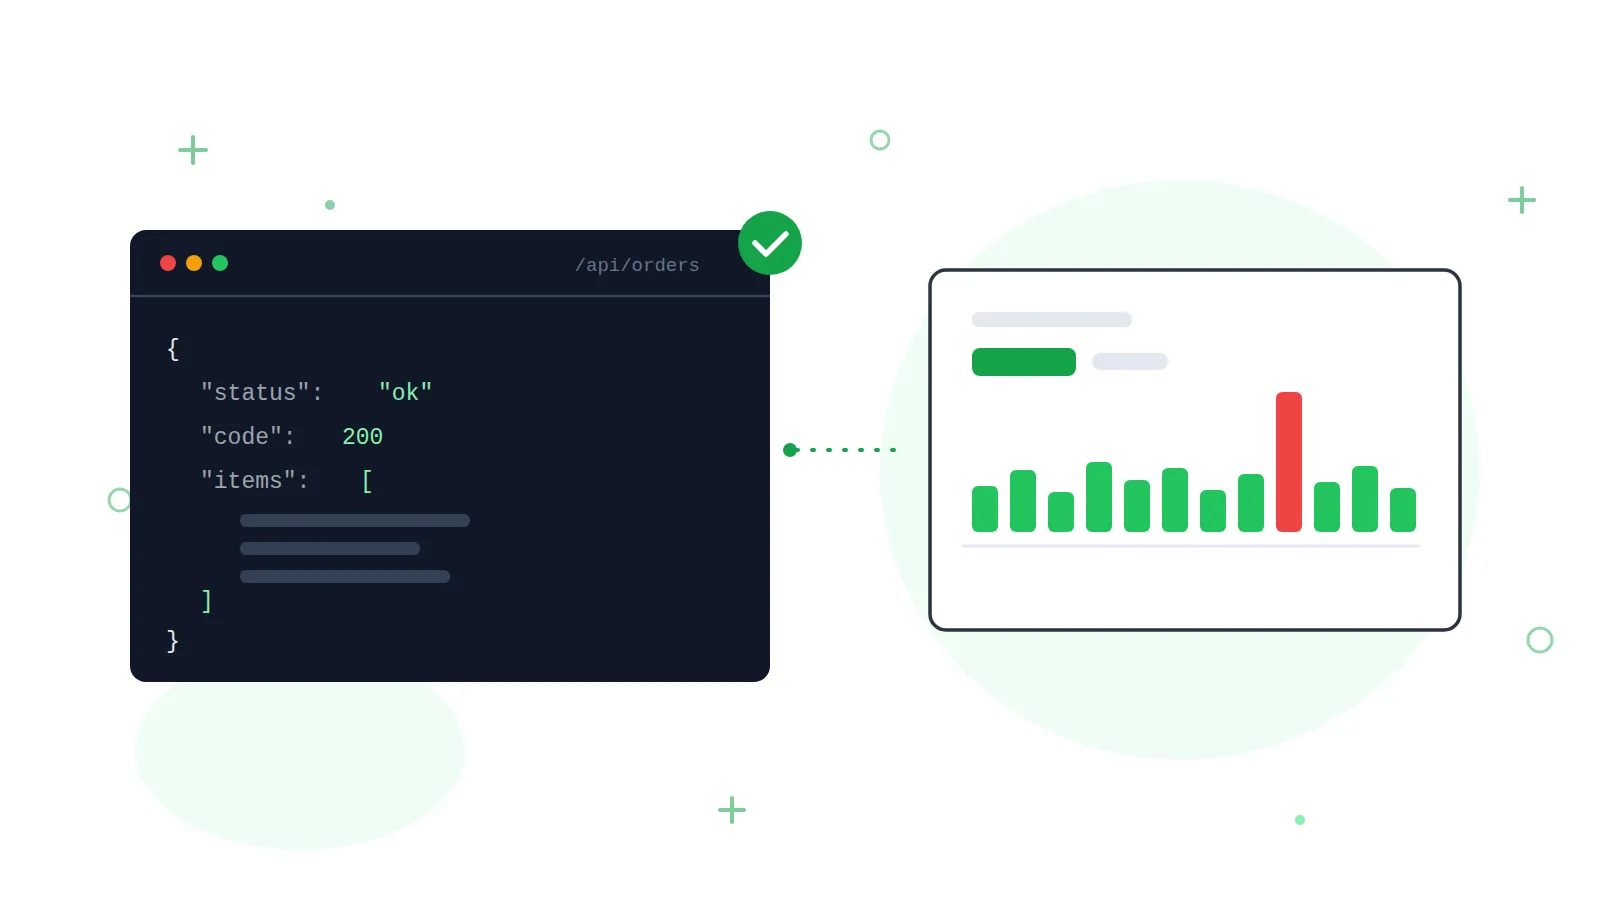
У сайта отказ виден глазами: страница не открылась. У API отказ выражается в структуре ответа, и код 200 здесь ничего не гарантирует. Endpoint может вернуть двести с пустым массивом вместо каталога, отдать ошибку внутри JSON-тела или начать отвечать за восемь секунд вместо двухсот миллисекунд — формально всё живо, фактически интеграция сломана.
Отсюда следует главный принцип: у API проверяют не факт ответа, а его содержание. Мониторинг должен смотреть внутрь тела ответа, а не только на код.
Что проверять у endpoint'а
| Параметр | Норма | Что ловит |
|---|---|---|
| Код ответа | 200 или 201 | Полное падение сервиса, 500 и 502 |
| Время ответа | Порог, вдвое выше обычного значения | Деградацию базы, зависшие внешние вызовы |
| Ключевое поле в теле | Строка или поле присутствует | Пустой ответ, ошибку внутри JSON, смену формата |
| SSL-сертификат домена API | Срок не истекает в ближайшие недели | Обрыв всех интеграций разом |
| Порт и сетевой отклик | Порт открыт, хост отвечает | Упавший сервис за прокси, проблемы сети |
Строчка про ключевое поле — самая полезная в таблице. Проверка на наличие конкретной строки в ответе отличает работающий endpoint от формально живого: если в теле пропало поле items или появилось error, вы узнаете об этом сразу, а не от партнёра через неделю.
Какие endpoint'ы брать под наблюдение
Ставить проверку на каждый метод бессмысленно и дорого. Разумный минимум складывается из четырёх групп.
Health-check. Отдельный лёгкий адрес вроде /api/health, который проверяет доступность базы и очередей и отвечает быстро. Это первая линия: он падает раньше остальных.
Денежный путь. Методы, без которых не проходит заказ: расчёт корзины, создание платежа, проверка остатков. Их простой измеряется прямыми потерями.
Внешние зависимости. Адреса, за которыми стоят чужие сервисы — платёжный шлюз, служба доставки, поставщик данных. Ломаются они не у вас, но отвечать за это перед клиентом будете вы.
Публичные методы для партнёров. Всё, что вы отдаёте наружу по договору: именно здесь тишина обходится дороже всего, потому что о поломке сообщает не система, а недовольный контрагент.
Закрытые методы удобно проверять отдельным техническим токеном с минимальными правами и на тестовых данных. Не используйте для мониторинга рабочий ключ администратора и следите за сроком его действия: истёкший токен превращает мониторинг в источник ложных тревог.
Пороги и борьба с ложными тревогами
Мониторинг, который кричит по любому поводу, перестают читать через неделю. Три настройки решают проблему.
Первая — интервал. Для денежных методов имеет смысл минимальный, для справочных достаточно проверки раз в 10–15 минут. Помните, что время обнаружения проблемы равно выбранному интервалу: проверка раз в час означает час незамеченного простоя.
Вторая — порог по времени ответа. Ставьте его не по идеальному значению, а по фактическому: посмотрите обычное время за неделю и возьмите запас. Порог впритык даст поток тревог на каждом всплеске нагрузки.
Третья — подтверждение из нескольких точек. Единичный таймаут из одной локации почти всегда означает сетевую икоту у конкретного провайдера, а не аварию API. Если о проблеме сообщают несколько географически разных точек, поломка настоящая.
В Пруфене endpoint закрывается связкой проверок: доступность по HTTP с интервалом от 2 минут следит за кодом ответа и временем, наличие контента — за нужной строкой в теле ответа, отдельные проверки — за сертификатом и портом. Точек 13: 11 в России, Минск и Испания. Уведомления приходят на Email, в Telegram, в Макс и звонком, а для интеграции с вашими системами есть REST API.
Частые вопросы
Разве логи и APM не закрывают эту задачу? Они показывают, что происходит внутри системы, но молчат, когда система недоступна снаружи целиком — например, при проблемах с DNS, сертификатом или каналом. Внешняя проверка смотрит на API глазами клиента, поэтому дополняет внутренний мониторинг, а не заменяется им.
Нужно ли мониторить чужое API, которым мы пользуемся? Да, если от него зависит ваш бизнес-процесс. Так вы узнаете о сбое поставщика раньше, чем он опубликует статус, и сможете вовремя переключиться на запасной сценарий.
Не создаст ли мониторинг лишнюю нагрузку? Запрос к лёгкому health-check раз в несколько минут незаметен на фоне рабочего трафика. Тяжёлые методы имеет смысл проверять реже или выносить для них отдельный облегчённый адрес.
Как проверять методы, изменяющие данные? Не проверять их напрямую в бою. Заведите тестовый контур или идемпотентный метод-заглушку, который проходит тот же путь по инфраструктуре, но не создаёт реальных записей.