
 Артём Савельев
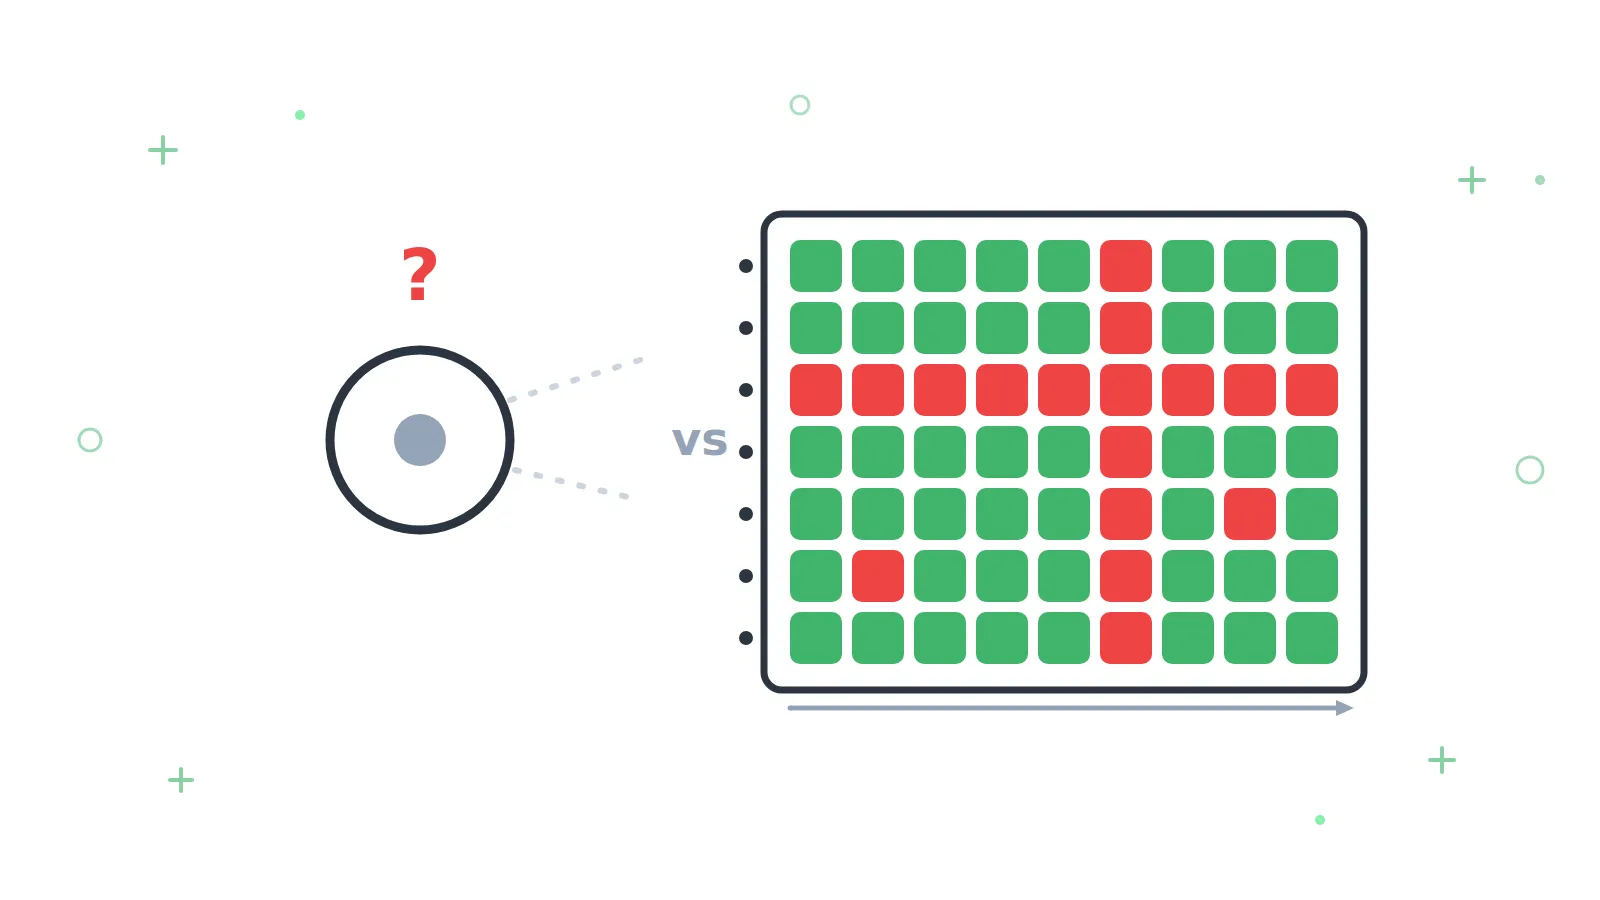
Мониторинг из одной точки: почему вы узнаете о падении сайта последним
Клиент из Новосибирска пишет: «У вас сайт не работает». Вы открываете — работает. Скрипт на сервере рапортует: всё зелёное. Кто врёт? Никто: вы оба смотрите на сайт из одной точки — каждый из своей — и честно описываете то, что видите. Разбираем с цифрами, почему наблюдение из одного места не отвечает на вопрос «работает ли сайт», сколько ложных тревог оно генерирует и как выглядит наблюдение, которое отвечает.
Начнём с тезиса, который стоит принять до всех таблиц. Проверка из одной точки отвечает только на один вопрос: «виден ли сайт из этой точки прямо сейчас». Вопрос «работает ли сайт» — другой вопрос, и из одной точки он не решается в принципе. Это не недостаток конкретного инструмента — это свойство самой задачи. Дальше — почему, и в каких количествах.
Что на самом деле проверяет одна точка
Когда проверка из точки А запрашивает ваш сайт, она проверяет не сайт, а цепочку: свой DNS-резолвер → свой канал → маршруты через сети операторов → ваш сервер → путь обратно. Успех означает, что исправна вся цепочка; провал — что сломано хотя бы одно звено, но не говорит, какое. Отсюда три класса ошибок одной точки.
Ложная тревога. Сбойнул резолвер точки, мигнул её канал — и вам прилетает «сайт упал», хотя сайт работает. Насколько это часто? Оценим консервативно: пусть отдельная проверка из-за сетевых флуктуаций ложно фейлится всего в 0,2% случаев — один раз из пятисот. При интервале 2 минуты это 21 600 проверок в месяц, то есть около 43 ложных тревог ежемесячно — больше одной в день. После первой недели такого потока уведомления перестают читать — и настоящее падение тонет в шуме. Спираль недоверия мы разбирали в статье про ложные срабатывания.
Слепая зона. Сайт недоступен для Сибири и Дальнего Востока, а московская точка смотрит по короткому здоровому маршруту и рапортует «всё в порядке». Масштаб слепоты легко оценить по распределению населения России:
| Макрорегион | Доля населения РФ | Видит ли её сбой точка в Москве |
|---|---|---|
| Москва и область | ~15% | Да |
| Остальной Центр и Северо-Запад | ~21% | Частично |
| Поволжье и Урал | ~28% | Нет |
| Юг и Северный Кавказ | ~19% | Нет |
| Сибирь и Дальний Восток | ~17% | Нет |
Читается таблица жёстко: региональные сбои, затрагивающие порядка 80% вашей потенциальной аудитории, московская точка в общем случае не видит. Она добросовестно сторожит свои ~15% и молчит про остальное.
Неверный диагноз. Даже поймав проблему честно, одна точка не скажет главного: сервер это или сеть? От ответа зависит, кому звонить — разработчику или хостингу. Одна точка видит только «не открылось».
Скрипт на сервере, проверяющий «жив ли сайт», — вырожденная версия одной точки: он смотрит изнутри, минуя DNS и сеть, обо что спотыкаются посетители, а при падении сервера умирает вместе с ним — молча. Статистика такого «мониторинга» всегда парадно-белая.
Несколько точек: как кворум убивает ложные тревоги
Одна точка — монетка. Несколько независимых точек — статистика. Вернёмся к модели с 0,2% ложных фейлов на проверку и посчитаем, что происходит, когда тревога требует подтверждения от нескольких точек одновременно (кворум по доле локаций — например, при трёх точках и пороге 50% инцидент открывают две из трёх):
| Схема подтверждения | Ложных тревог | Что это значит |
|---|---|---|
| 1 точка, тревога по одному фейлу | ~43 в месяц | Больше одной в день; уведомления перестают читать |
| Кворум 2 из 3 | ~0,3 в месяц | Одна ложная за квартал — в 160 раз меньше |
| Кворум 3 из 5 | ~1 за 48 лет | Ложные тревоги как явление исчезают |
| Кворум 7 из 13 | ~0 | Сработал — значит, сайт действительно лежит |
Расчёт модельный (независимые точки, равная вероятность фейла), но порядок величин честный, и вывод устойчив: переход от одной точки к кворуму из трёх меняет качество жизни на два порядка, а не на проценты. При этом чувствительность к частичным сбоям не теряется, а настраивается порогом: жёстче порог — тише жизнь, мягче — раньше видите региональные проблемы. Как пороги устроены у нас — в справке об инцидентах и порогах; как задачу подтверждения решают разные сервисы — в нашем сравнении механик.
Оговорка про независимость: три проверки из одного московского датацентра — это одна точка, посчитанная трижды, у них общие маршруты и общие сбои. Ценность дают точки в разных городах и сетях — зачем именно, мы разбирали в статье про мониторинг из городов России.
Матрица «локации × время»: диагноз по узору
Самый информативный взгляд на доступность — не число «аптайм 99,9%», а матрица: по строкам локации, по столбцам запуски. Так устроена вкладка «По локациям» в Пруфене. Вот как в такой матрице выглядят четыре типовых сбоя — шесть локаций, двенадцать запусков с шагом 2 минуты:
| Москва | ||||||||||||
| Петербург | ||||||||||||
| Казань | ||||||||||||
| Екатеринбург | ||||||||||||
| Новосибирск | ||||||||||||
| Хабаровск | ||||||||||||
| → запуски проверки, шаг 2 минуты | ||||||||||||
В этой картинке — три диагноза одновременно. Вертикальная полоса (4-й запуск красный у всех) — сайт падал целиком, ищите причину в сервере и логах за это время. Горизонтальная полоса (Новосибирск красный весь период) — регион отрезан: маршрут, фильтрация или гео-настройка; сайт «работает», но не для Сибири. Одиночные пятна (Казань, Хабаровск) — «мигание»: перегрузка или нестабильный бэкенд, разбор в статье про мигающие сайты. Обратите внимание на строку «Москва»: с точки зрения одной московской точки этот сайт за весь период сбойнул один раз на две минуты — аптайм 98%+, не о чем говорить. Реальность: Сибирь отрезана полностью. Одна точка видит одну строку; диагноз рождается из сравнения строк.
Постоянство: арифметика пропущенных сбоев
Матрице нужна не только ширина (локации), но и длина (время). Вероятность, что проверка с интервалом I поймает сбой длиной T, — это примерно T/I. В цифрах:
| Интервал проверки | Сбой 1 мин | Сбой 3 мин | Сбой 5 мин | Сбой 15 мин |
|---|---|---|---|---|
| 2 минуты | 50% | 100% | 100% | 100% |
| 15 минут | 7% | 20% | 33% | 100% |
| 30 минут | 3% | 10% | 17% | 50% |
| 60 минут | 2% | 5% | 8% | 25% |
А теперь сравните с посетителями. При скромном трафике 100 человек в час на трёхминутный сбой попадает в среднем пять живых людей — со стопроцентной вероятностью, потому что они приходят непрерывно. Мониторинг с получасовым интервалом заметит тот же сбой с вероятностью 10%. То есть при редких проверках ваши клиенты — более чувствительный мониторинг, чем ваш мониторинг; они просто не присылают уведомлений — они уходят. Сайт, доступный из Казани 97% времени, — это 13 часов недоступности в месяц, и на любом разовом снимке он выглядит здоровым. Нестабильность видна только в длинной истории с коротким шагом; как выбирать интервал — в отдельном разборе.
Сайт должен открываться ±одинаково по всей стране
Если бизнес работает на всю Россию, мало быть доступным из всех регионов — нужно открываться из них сопоставимо быстро. Сначала отделим физику от проблем. Свет в оптоволокне не обмануть: каждый обмен пакетами между Москвой и Владивостоком стоит десятков миллисекунд просто из-за расстояния. Вот честные ориентиры для сервера, стоящего в Москве:
| Город | Расстояние | Физический минимум RTT | Типичный RTT |
|---|---|---|---|
| Санкт-Петербург | ~700 км | ~9 мс | 15–25 мс |
| Казань | ~820 км | ~10 мс | 17–26 мс |
| Екатеринбург | ~1 800 км | ~23 мс | 37–57 мс |
| Новосибирск | ~2 800 км | ~36 мс | 57–89 мс |
| Владивосток | ~6 400 км | ~82 мс | 130–200 мс |
Это RTT одного обмена пакетами (подробнее о его физике — в статье про ping). Но загрузка страницы — это не один обмен, а десятки: DNS, TCP, TLS, запрос, подгрузка ресурсов, и каждый умножает базовую задержку. Поэтому разница «82 мс против 9 мс» на уровне пакетов превращается на уровне страницы в разницу «две секунды против половины». Насколько — видно по живым цифрам с нашей страницы мониторинга популярных сайтов: замер полной загрузки главных страниц (GET) от 20.08.2026 даёт разброс от 240 мс у tanki.su и 265 мс у lenta.ru до 969 мс у kinopoisk.ru и 1 516 мс у pochta.ru — при том что все эти сайты формально «работают» и отдают 200-й код. Между лучшим и худшим — разница в шесть раз; ровно такого же порядка разница бывает у одного и того же сайта между «из Москвы» и «из дальнего региона», если инфраструктура собрана без оглядки на географию.
Правило чтения простое: стабильный разброс в полтора-два раза между ближними и дальними регионами — это физика; разброс в пять-десять раз — это проблема: неоптимальный маршрут, отсутствие кэширования статики, перегруженная единственная площадка. И это управляемая метрика: CDN или вторая площадка сжимают географический разброс в разы. Но управлять можно только тем, что измеряешь, — а измеряет это ровно матрица по локациям, если смотреть в ней не только на цвет ячеек, но и на время ответа. Тринадцать строк истории — это профиль скорости вашего сайта по стране.
Итог: три уровня зрелости наблюдения
| Уровень | Что видите | Чего не видите |
|---|---|---|
| 1. Одна точка | Сайт виден из одного места | Региональные сбои (~80% аудитории), диагноз «сервер или сеть», плюс ~43 ложные тревоги/мес |
| 2. Кворум точек | Подтверждённые падения, частичные сбои, диагноз по узору матрицы | Нестабильность на дистанции, деградацию скорости |
| 3. Кворум + история | Мигание, базовые линии, профиль скорости по стране | — |
Расстояние между уровнями — не бюджет и не команда инженеров, а несколько минут настройки: выбрать локации, задать порог, поставить интервал — дальше матрица наполняется сама.
Пруфен проверяет сайт из 13 точек — 11 из них в России — с интервалом от 2 минут, подтверждает инциденты порогом по доле локаций и показывает вкладку «По локациям» — ту самую матрицу, по которой сбой диагностируется за минуту: сервер, регион или мигание. Уведомления — Email, Telegram, Макс или звонок. Бесплатного тарифа хватает на 5 проверок.