
 Артём Савельев
Как сервисы мониторинга подтверждают падение сайта: Пруфен, UptimeRobot, Pingdom, StatusCake и другие
Между «одна проверка вернула ошибку» и «у вас инцидент» лежит самая интересная часть мониторинга — механика подтверждения. Именно она решает, разбудит ли вас сервис из-за мигнувшего канала и заметит ли, что сайт лёг для половины страны. Разбираем, как эту задачу решают шесть сервисов, — по их публичной документации, с честными оговорками о том, чего в ней нет.
Материал основан на публичной документации сервисов по состоянию на август 2026 года. Механики и значения по умолчанию меняются — если заметите расхождение, напишите нам, обновим.
Две архитектуры подтверждения
Задача у всех одна: отличить настоящее падение от помехи. Интернет — среда с потерями: теряются пакеты, перестраиваются маршруты, у оператора на полминуты подтормаживает магистраль. Мониторинг, который поднимает тревогу по первой же неудачной проверке, быстро превращается в фон — на него перестают реагировать и пропускают настоящую аварию.
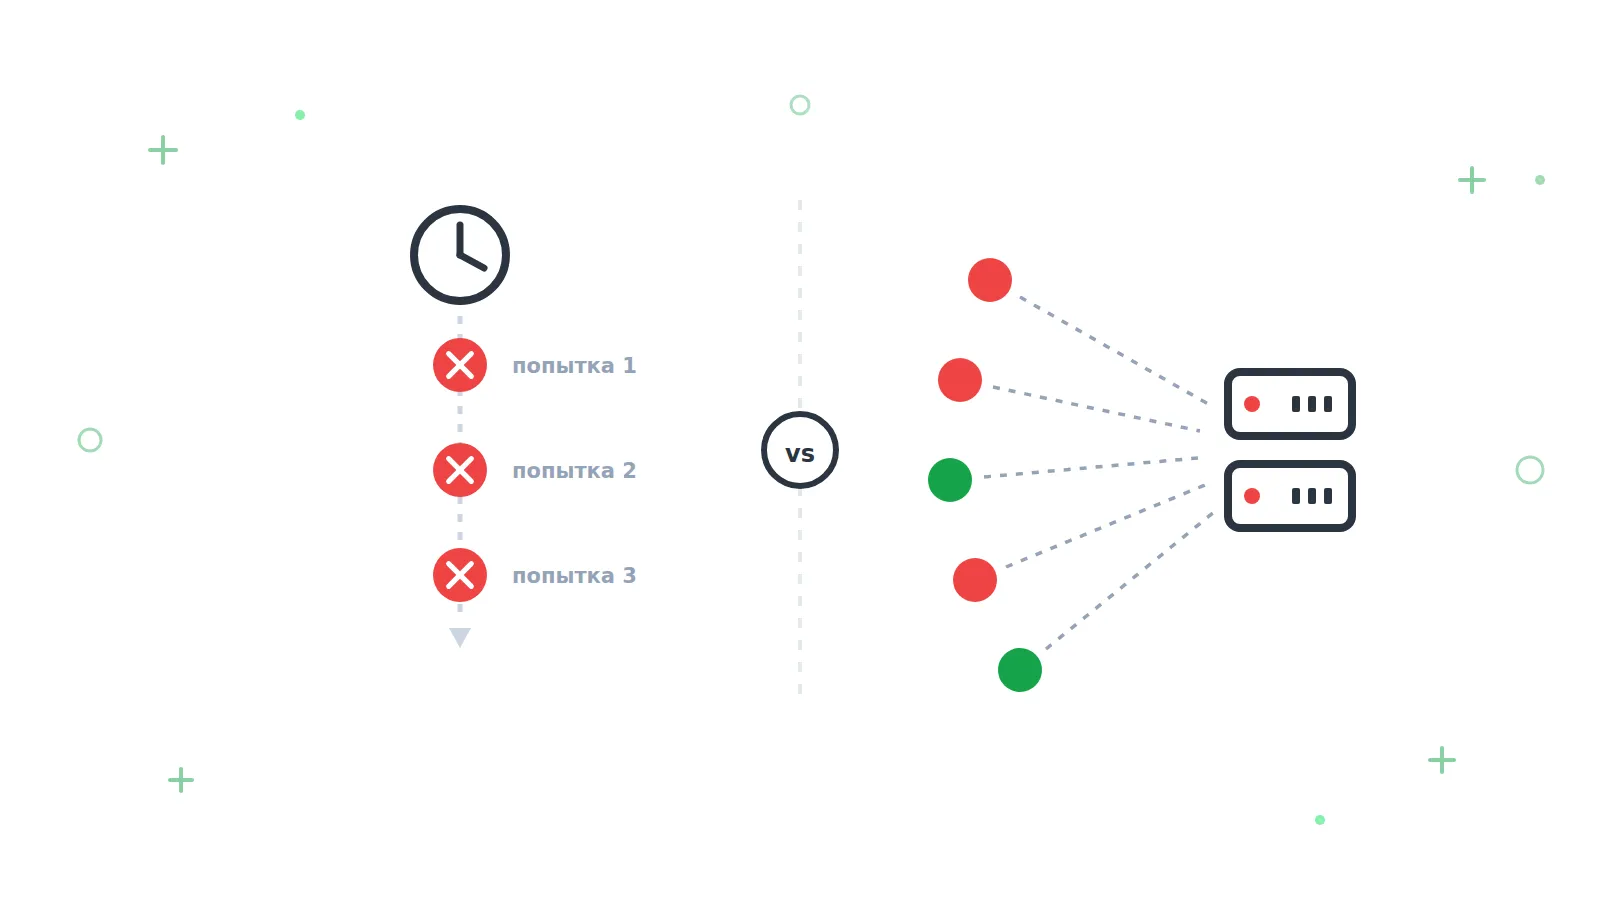
Способов подтвердить сбой ровно два, и они принципиально разные:
| Подход | Логика | На какой вопрос отвечает |
|---|---|---|
| Временно́е подтверждение | Сбой должен повториться во времени: N попыток подряд, N секунд, N дополнительных тестов | «Это надолго или моргнуло?» |
| Пространственное подтверждение (кворум) | Сбой должен подтвердиться одновременно из нескольких географических точек | «Это у сайта или на пути к одной точке?» |
Разница не косметическая. Временно́е подтверждение честно отвечает на свой вопрос, но не различает «сайт лежит» и «канал до нашего пробника мигает уже минуту». Пространственное отвечает сразу на два вопроса — «сайт действительно недоступен?» и «для кого именно?», — но требует инфраструктуры: точки должны опрашивать сайт одновременно, а не по очереди.
Временна́я ветка: как это работает у четырёх сервисов
UptimeRobot. В справке описан режим round-robin: каждая отдельная проверка выполняется из одной локации, регионы чередуются между проверками. Одновременного голосования нескольких точек по одной проверке нет. Когда проверка падает, запускается серия перепроверок в том же регионе — до трёх попыток с интервалом порядка 10–20 секунд. Монитор помечается Down, если какой-то один регион трижды подряд не увидел сайт. А вот восстановление устроено асимметрично: чтобы монитор снова стал Up, подняться должны все регионы.
StatusCake. Двухступенчатая схема: первичную проверку делает один сервер выбранного региона, при обнаружении недоступности запускаются confirmation-тесты — дополнительные серверы перепроверяют сайт, и только после подтверждения уходит уведомление. Количество подтверждений настраивается в диапазоне от 0 до 3, причём документация прямо предупреждает, что вариант «0 подтверждений» быстрее, но несёт более высокий риск ложных срабатываний. Важная деталь: подтверждающие серверы берутся из того же региона мониторинга — это отсекает случайность конкретного канала, но не отвечает на вопрос, глобальная проблема или региональная. Значение по умолчанию в разных статьях их базы знаний указано по-разному (2 и 3), так что его стоит уточнять в интерфейсе.
Pingdom. Механизм называется Second Opinion и устроен изящно: когда пробник не может подключиться к сайту, проверка получает промежуточный статус Unconfirmed Down и запускается тест из другой точки — причём система намеренно выбирает максимально географически удалённую локацию, чтобы легче было определить, где именно проблема. Инцидент подтверждается, только если второй тест тоже провалился. Формально это тоже временно́е подтверждение (второй тест идёт после первого), но с географическим разнесением — гибрид.
Better Stack. Самая чистая временна́я схема: два параметра — confirmation period (сколько ждать после обнаружения сбоя перед открытием инцидента) и recovery period (сколько монитор должен быть в порядке, чтобы инцидент закрылся автоматически). Причём при восстановлении все проверки внутри recovery period должны пройти успешно — любой сбой сбрасывает счётчик. Требований к подтверждению из нескольких регионов в этом документе нет, значения по умолчанию не раскрыты.
Обратите внимание на правило UptimeRobot: инцидент открывается, если сайт не увидел один регион, а закрывается, только когда его увидят все. Одна деградировавшая точка — например, с испортившейся сетью — способна держать инцидент открытым сколь угодно долго, хотя сайт давно работает. Это не баг, а следствие архитектуры: когда решение принимается по одной локации за раз, симметричного правила закрытия просто неоткуда взять.
Пространственная ветка: кворум
Site24x7. Заявлено более 130 глобальных локаций. При сообщении о недоступности от одной точки платформа не отправляет алерт сразу, а инициирует перепроверку из альтернативных локаций. Порог настраивается и может быть выражен в количестве точек: в описанном ими кейсе компания мониторит из 15 локаций на разных континентах, а алерт срабатывает, только если минимум три локации сообщили о недоступности после вторичной проверки. Точный алгоритм различения глобального и локального сбоя и значения по умолчанию в публичных материалах не раскрыты.
Пруфен. Все привязанные к проверке точки — их может быть до 13: 11 в России, Минск и Испания — получают задачу одновременно, окно между первой и последней локацией обычно 20–30 секунд. Дальше считается доля недоступности по локациям, и решение принимается по двум независимым порогам: инцидент открывается, когда доля неуспешных проверок достигла порога недоступности, и закрывается, когда доля успешных достигла порога восстановления. Пример из нашей справки: при трёх точках и пороге 50% инцидент откроется, когда ошибку вернут две из трёх. Подробную механику всей цепочки — от проверки до уведомления — мы разобрали в статье о том, как работает мониторинг в Пруфене.
Сводная таблица
| Сервис | Тип подтверждения | Механика | Единица порога | Откуда подтверждение |
|---|---|---|---|---|
| Пруфен | Пространственное | Все точки одновременно, доля недоступности | Процент + гистерезис | Все привязанные локации |
| UptimeRobot | Временно́е | До 3 повторов через 10–20 сек | Счётчик подряд | Тот же регион |
| StatusCake | Временно́е | 0–3 confirmation-теста | Число подтверждений | Тот же регион |
| Pingdom | Временно́е + гео | Second Opinion после Unconfirmed Down | Одно подтверждение | Максимально удалённая точка |
| Better Stack | Временно́е | Confirmation / recovery period | Время | Не документировано |
| Site24x7 | Пространственное | Перепроверка из альтернативных локаций | Число локаций | Другие локации |
Отдельно стоит отметить единицу порога. У большинства сервисов это счётчик, количество или время; процентная доля с двумя разными порогами — на открытие и на закрытие — среди рассмотренных шести встречается только у Пруфена. Разница практическая: счётчиком подряд идущих сбоев нельзя выразить условие «сайт недоступен для половины страны», а долей — можно.
Что это значит на практике: четыре сценария
| Ситуация | Временно́е подтверждение | Кворум |
|---|---|---|
| Мигнул канал до одного пробника на 30 секунд | Ретраи идут из того же региона — могут провалиться все три, будет ложный инцидент | Остальные точки видят сайт, порог не пробит, тревоги нет |
| Сайт недоступен для половины страны (сбой магистрали, региональный сбой CDN) | Зависит от везения: если очередная проверка попала на здоровый регион — не заметит | Видно сразу и в цифрах, и по карте: какие города красные |
| Сайт лёг полностью, нужна скорость реакции | Подтверждение стоит времени: до минуты на ретраи | Подтверждение уже собрано в том же тике — времени не добавляет |
| Одна точка деградировала и «залипла» | У UptimeRobot держит инцидент открытым, пока не поднимутся все регионы | Порог восстановления закрывает инцидент, не дожидаясь стопроцентного согласия |
Справедливости ради: у временно́й ветки есть и свои сильные стороны, которые стоит признать. Промежуточный статус Unconfirmed Down у Pingdom — честная и полезная штука: он объясняет пользователю провал на графике, за которым не последовало инцидента, вместо того чтобы молча его проглотить. Явная опция «открывать инцидент немедленно» у Better Stack — правильное решение для критичных сервисов, где важна каждая секунда. А порог, выраженный в количестве локаций, как у Site24x7, для многих понятнее процентов и надёжнее на маленьких наборах точек.
Где не поможет ни один кворум
Есть класс ложных срабатываний, против которого пространственное подтверждение бессильно по определению, — и в зарубежной документации о нём почти не пишут, потому что для их рынка он менее актуален. Это анти-бот защита: DDoS-Guard, Qrator, Cloudflare и подобные системы отдают автоматическим запросам 403 или JS-челлендж, в то время как живой посетитель открывает сайт нормально. Кворум здесь не спасает: блокируются не отдельные точки, а все сразу — они все автоматические.
Лечится это не алгоритмами подтверждения, а настройкой: адреса проверяющих серверов вносятся в белый список защиты. Показательно, что StatusCake называет незанесённые в белый список IP причиной ложных срабатываний номер один, а Pingdom — самой частой причиной, по которой они сообщают о недоступности работающего сайта. Мы публикуем адреса своих точек на странице серверов мониторинга в виде готовых списков — как раз для внесения в исключения; сам сценарий «защита воюет с мониторингом» мы разбирали в статье про WAF.
Что из этого выбирать
Механика подтверждения — не единственный критерий выбора мониторинга и, честно говоря, не первый: сначала смотрят на состав проверок, географию точек и организационные вопросы вроде оплаты и документов. Полное сравнение по возможностям — в отдельной статье про аналоги UptimeRobot в России; здесь мы намеренно разобрали только один узел, зато глубоко.
Но когда состав проверок сопоставим, именно этот узел определяет, будете вы доверять уведомлениям или начнёте их игнорировать. Практическое правило: если ваша аудитория сосредоточена в одной стране и вам важно различать «упал сайт» и «упал сегмент сети» — ищите пространственное подтверждение и настраиваемые пороги. Если аудитория глобальная и вопрос «для кого именно лежит» вторичен — временно́го подтверждения с ретраями обычно достаточно.
Пруфен проверяет сайт одновременно из 13 точек — 11 в России, Минск и Испания — с интервалом от 2 минут, а решение об инциденте принимает по доле недоступных локаций. Пороги открытия и закрытия настраиваются отдельно, поэтому мониторинг не дребезжит на границе срабатывания. Бесплатный план — 5 проверок без ограничения по времени.
Частые вопросы
Какой подход объективно лучше? Для задачи «отличить падение сайта от сетевой помехи» пространственное подтверждение отвечает точнее: оно проверяет гипотезу одновременно из независимых точек, а не повторяет один и тот же запрос по одному и тому же маршруту. Но у него есть цена — инфраструктура из множества точек, — и он не отменяет временны́х механизмов: задержка уведомлений в Пруфене решает как раз временну́ю задачу, отсекая микропадения при деплое.
Почему мониторинг вообще ошибается? Потому что «доступен» — не бинарное свойство сайта, а результат измерения через сеть, у которого есть погрешность. Задача сервиса — не устранить погрешность (это невозможно), а сделать её управляемой: порогами, задержками и подтверждениями. Подробнее с примерами — в статье про ложные срабатывания.
Насколько этим данным можно верить? Всё описанное взято из публичной документации сервисов и справки Пруфена. Там, где документация не раскрывает деталей — значения по умолчанию Better Stack и Site24x7, актуальное число confirmation-серверов StatusCake, — мы прямо это отметили, а не додумали. Механики со временем меняются: проверяйте в актуальной справке, если решение зависит от конкретной цифры.
Зачем вообще проверять из нескольких городов? Затем, что доступность сайта — величина географическая: он может нормально открываться в Москве и не открываться за Уралом из-за сбоя магистрали, блокировки или гео-фильтра. Развёрнутый ответ — в статье про мониторинг из разных городов России.