
 Максим Дорохов
Инцидент-менеджмент для сайта: MTTD, MTTR, постмортем и дежурства без бюрократии
Сайт падает у всех. Разница в том, через сколько минут об этом узнают, кто берёт управление, как быстро поднимают и повторится ли это через месяц. Процесс на команду из трёх человек: что считать инцидентом, как считать MTTD, MTTA, MTTR и MTBF, сколько минут прячется за «тремя девятками», как дежурить, не просыпаясь из-за 40-секундного микропадения, и как писать постмортем, после которого что-то меняется.
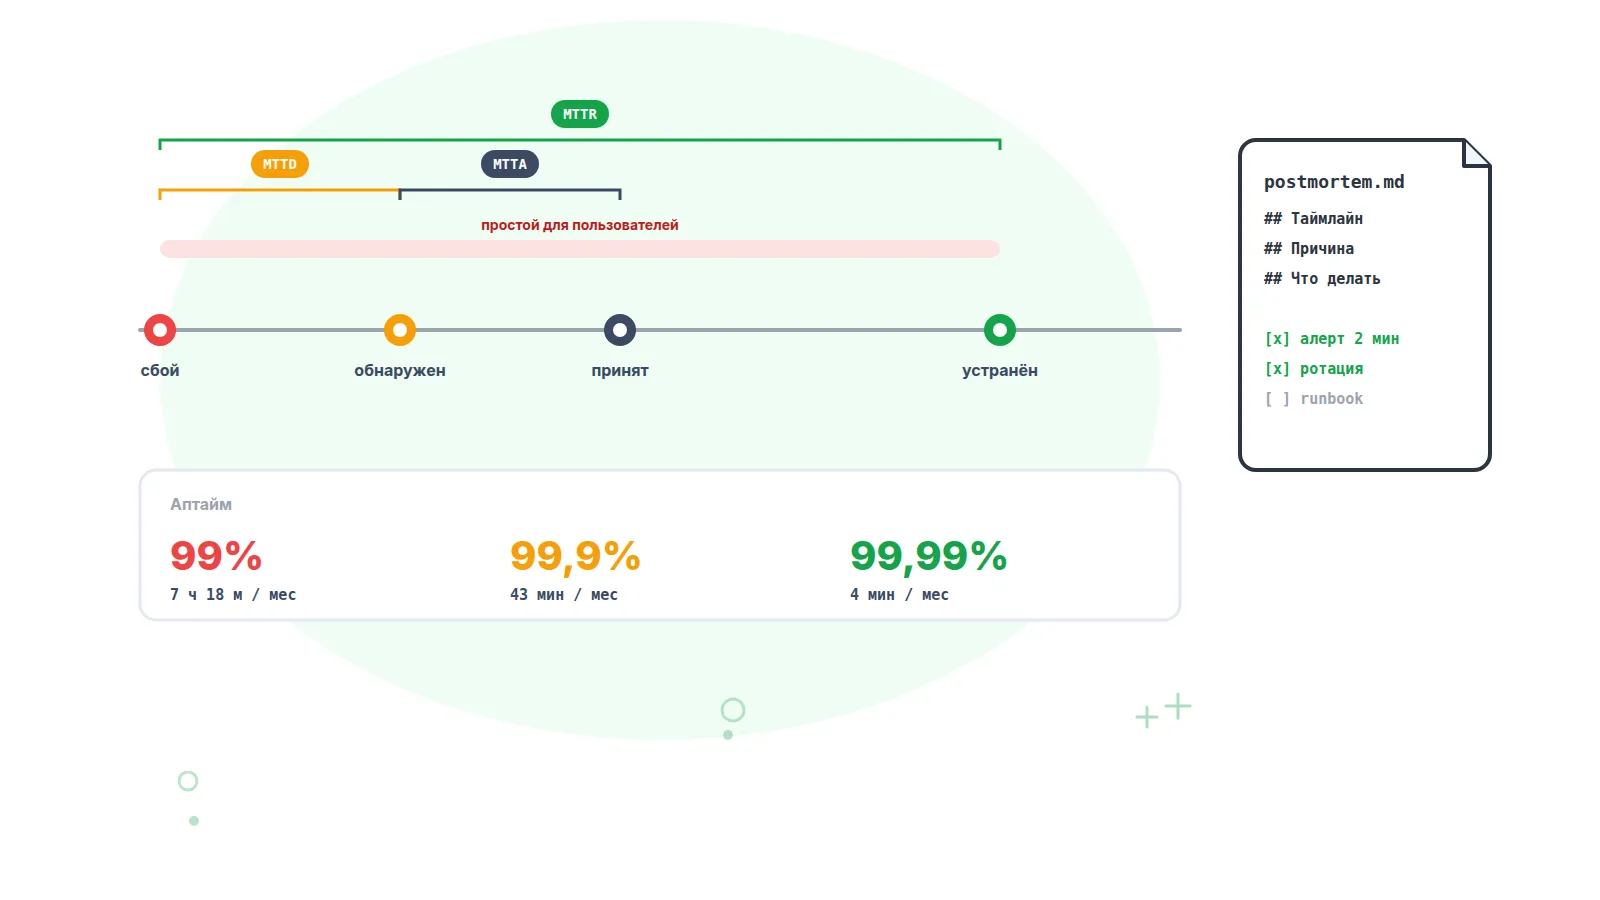
Инцидент-менеджмент — процесс обнаружения, подтверждения, устранения и разбора событий, которые нарушают работу сервиса для пользователей. Его качество измеряют временем: от начала сбоя до обнаружения (MTTD), до реакции дежурного (MTTA) и до восстановления (MTTR), а результат разбора фиксируют в постмортеме — письменном отчёте с таймлайном, причиной и задачами, которые не дадут сбою повториться. Небольшой команде хватает четырёх вещей: мониторинга, который узнаёт о падении раньше клиентов, одного ответственного на время инцидента, правила эскалации по времени и шаблона постмортема на страницу.
Чем инцидент отличается от алерта и от проблемы
Алерт — сигнал от мониторинга, инцидент — подтверждённое нарушение работы сервиса, проблема — причина, из-за которой инциденты повторяются. Это три объекта с разным жизненным циклом, а путаница начинается там, где все три называют словом «упало».
В глоссарии ITIL 4 инцидент — «незапланированное прерывание сервиса или снижение его качества», проблема — «причина или потенциальная причина одного или нескольких инцидентов». Atlassian в Incident Management Handbook уточняет: инцидент — событие, которое «требует экстренной реакции». Отсюда правило: не всякий алерт — инцидент, а корневую причину ищут после восстановления, а не вместо него.
Google в SRE Book называет три условия, при любом из которых стоит объявлять инцидент: нужна вторая команда, сбой виден клиентам, проблема не решена после часа сосредоточенного анализа. Втроём первое условие превращается в «нужен второй человек»: если разбудили одного и он справился за десять минут — это запись в журнале; если пришлось звонить коллеге — инцидент с постмортемом.
Какие метрики считать: MTTD, MTTA, MTTR и MTBF
Четырёх метрик достаточно, и все они — среднее время между событиями в жизни инцидента: началом, обнаружением, реакцией и восстановлением. Проблема не в формулах, а в том, что MTTR расшифровывается четырьмя способами, и команды сравнивают несравнимое.
Atlassian в справочнике по метрикам (сверено на сентябрь 2026) различает: mean time to repair — только сама починка; mean time to recovery — «от падения до полного восстановления», вся длительность простоя; mean time to respond — «от первого уведомления» до восстановления, без периода, пока никто не знал о сбое; mean time to resolve — обнаружение, диагностика, починка и «работа, гарантирующая, что сбой не повторится». Для сайта берите recovery: клиенту всё равно, когда вы узнали и когда закрыли задачу, ему важно, сколько минут не открывалась корзина.
| Метрика | Что измеряет | Формула | Пример (выдуманные цифры) |
|---|---|---|---|
| MTTD, time to detect | От начала сбоя до момента, когда о нём узнала команда | Σ (обнаружено − началось) / число инцидентов | 2 + 2 + 5 + 2 = 11 мин / 4 → 2,75 мин |
| MTTA, time to acknowledge | От уведомления до момента, когда дежурный взял инцидент в работу | Σ (взято − уведомлено) / число инцидентов | 17 + 2 + 2 + 1 = 22 мин / 4 → 5,5 мин |
| MTTR, time to recovery | От начала сбоя до восстановления для пользователей | Σ простоев / число инцидентов | 50 + 18 + 15 + 100 = 183 мин / 4 → 45,75 мин |
| MTBF, time between failures | Среднее время работы между сбоями | Время работы за период / число сбоев | (43 200 − 183) / 4 = 10 754 мин ≈ 179 ч |
| Аптайм | Доля времени, когда сервис работал | 1 − Σ простоев / длина периода | 1 − 183 / 43 200 = 99,576 % за 30 дней |
Определение MTBF («среднее время между ремонтопригодными отказами») и формула — из того же справочника Atlassian; там же пример: 720 часов работы с двумя отказами дают MTBF 360 часов. Аптайм = MTBF / (MTBF + MTTR): поднять его можно, реже падая или быстрее поднимаясь, и второй путь для небольшой команды почти всегда дешевле. Считать руками не нужно — достаточно журнала с четырьмя метками времени на инцидент:
# incidents.csv — четыре выдуманных инцидента за сентябрь
id,started,detected,acked,recovered
INC-1,2026-09-02 03:12,2026-09-02 03:14,2026-09-02 03:31,2026-09-02 04:02
INC-2,2026-09-09 14:40,2026-09-09 14:42,2026-09-09 14:44,2026-09-09 14:58
INC-3,2026-09-15 21:05,2026-09-15 21:10,2026-09-15 21:12,2026-09-15 21:20
INC-4,2026-09-23 11:30,2026-09-23 11:32,2026-09-23 11:33,2026-09-23 13:10

# mttr.py
import csv
from datetime import datetime as dt
f = "%Y-%m-%d %H:%M"
rows = list(csv.DictReader(open("incidents.csv")))
m = lambda a, b: (dt.strptime(b, f) - dt.strptime(a, f)).seconds / 60
n = len(rows)
ttd = [m(r["started"], r["detected"]) for r in rows]
tta = [m(r["detected"], r["acked"]) for r in rows]
ttr = [m(r["started"], r["recovered"]) for r in rows]
print(f"MTTD {sum(ttd)/n:.1f} min")
print(f"MTTA {sum(tta)/n:.1f} min")
print(f"MTTR {sum(ttr)/n:.1f} min, downtime {sum(ttr):.0f} min")
period = 30 * 24 * 60
print(f"uptime {100 * (1 - sum(ttr) / period):.3f} %")
print(f"MTBF {(period - sum(ttr)) / n / 60:.1f} h")

$ python3 mttr.py
# пример вывода
MTTD 2.8 min
MTTA 5.5 min
MTTR 45.8 min, downtime 183 min
uptime 99.576 %
MTBF 179.2 h
MTTD здесь задан интервалом проверки, MTTA испорчен ночным инцидентом (дежурный проснулся через 17 минут), MTTR тянет вверх один долгий INC-4. Среднее это скрывает — рядом смотрите медиану и максимум: 34 и 100 минут.
Сколько минут простоя прячется за «девятками»
«Три девятки» — 43 минуты простоя в месяц, «четыре» — 4 минуты, и один инцидент длиной с обед съедает месячный бюджет обоих. Таблица — наш расчёт для месяца в 30 дней (43 200 минут) и года в 365 дней (525 600 минут); в SLA хостеров период и округление могут отличаться.
| Аптайм | Простой в месяц | Простой в год | Что это значит |
|---|---|---|---|
| 99 % | 432 мин = 7 ч 12 мин | 5 256 мин = 3,65 сут | Рабочий день простоя в месяц; для магазина — проблема |
| 99,5 % | 216 мин = 3 ч 36 мин | 2 628 мин = 43,8 ч | Типичный сайт на виртуальном хостинге без дежурств |
| 99,9 % | 43,2 мин | 525,6 мин = 8,76 ч | INC-4 из примера (100 мин) выбирает бюджет двух месяцев |
| 99,95 % | 21,6 мин | 262,8 мин = 4,38 ч | Нужно дежурство с реакцией за минуты, а не за час |
| 99,99 % | 4,32 мин | 52,56 мин | Человек не успевает: нужны автоматический failover и резерв |
| 99,999 % | 26 с | 5,26 мин | Телеком и платёжные системы; для сайта недостижимо и не нужно |
При цели 99,9 % бюджет — 43 минуты в месяц, и тратится он не столько на починку, сколько на позднее обнаружение: проверка раз в 15 минут даёт MTTD около 7–8 минут, то есть до 20 % бюджета уходит до того, как кто-то открыл ноутбук; интервал 2 минуты снижает долю до нескольких процентов. Для ориентира по цене: по данным Annual Outage Analysis 2025 от Uptime Institute, 54 % опрошенных оценили последний значимый сбой дороже 100 000 долларов, каждый пятый — дороже миллиона. Это выборка дата-центров, а не сайтов, но порядок величин показателен.
Как устроен жизненный цикл инцидента и кто что делает втроём
Инцидент проходит шесть этапов — обнаружение → подтверждение → эскалация → устранение → восстановление → постмортем, — и на каждом решения принимает один человек. Роли «больших» методик (incident commander, operations lead, коммуникатор у Google; incident manager, tech lead, communications manager у Atlassian) втроём складываются в двух человек, но не исчезают. Ключевая идея SRE Book — командир инцидента не чинит: он держит картину, раздаёт задачи и решает, когда эскалировать, а «только операционная группа меняет систему во время инцидента». Второй принцип — явная передача командования («теперь ведёшь ты») с подтверждением. Это звучит бюрократично ровно до первого инцидента, в котором двое одновременно перезапускали разные сервисы и сделали хуже.
| Этап | Что происходит | Кто отвечает | Метка |
|---|---|---|---|
| Обнаружение | Мониторинг фиксирует сбой; хуже — пишет клиент | Мониторинг, не человек | detected |
| Подтверждение | Сбой виден из нескольких точек; дежурный пишет «беру» в канал | Дежурный = командир | acked |
| Эскалация | Присвоен уровень SEV; нет гипотезы за 15 минут — зовут второго | Командир зовёт, второй становится «руками» | escalated |
| Устранение | Сначала остановить ущерб (откат, резерв, заглушка), потом чинить | Один меняет систему, командир пишет клиентам | mitigated |
| Восстановление | Мониторинг подтверждает ответ из всех точек | Командир объявляет закрытие | recovered |
| Постмортем | За 1–3 рабочих дня: таймлайн, причина, задачи | Пишет командир, читают все | postmortem |
Роль коммуникатора достаётся командиру: пока один в консоли, кто-то раз в 20–30 минут пишет клиентам и руководству два предложения — что сломано и когда следующий апдейт. Инцидент, о котором сообщил клиент, а не мониторинг, — сам по себе повод для постмортема: SRE Book включает «сбой мониторинга, из-за которого инцидент обнаружили вручную» в список триггеров. Почему MTTD зависит от числа точек проверки — в статье о мониторинге из одной точки.
Как назначать уровни серьёзности SEV1–SEV3
Уровень серьёзности определяет одно: кого будить и как быстро. Трёх уровней для сайта достаточно: PagerDuty использует пять (SEV-1 — «критическая проблема, требующая публичного уведомления и связи с руководством», SEV-5 — косметика), Atlassian — три, где Severity 1 — «критический инцидент с очень высоким влиянием» вроде потери данных клиентов, а Severity 3 — «незначительный инцидент с низким влиянием».
| Уровень | Критерий | Примеры для сайта и магазина | Реакция |
|---|---|---|---|
| SEV1 | Сервис недоступен для всех или большинства; под угрозой данные или деньги | 5xx из всех точек; не проходит оплата; истёк сертификат; домен в реестре блокировок | Будить в любое время; второй человек через 15 мин; статус клиентам за 30 мин; постмортем обязателен |
| SEV2 | Сломана важная функция или сервис недоступен части пользователей | Каталог работает, поиск нет; 404 на группе страниц в одном регионе через CDN; время ответа выросло в 5 раз | Будить днём и вечером; ночью — если длится дольше 30 мин; постмортем обязателен |
| SEV3 | Неудобство с обходным путём; риск без текущего влияния | До истечения сертификата 7 дней; диск заполнен на 85 %; одна точка из двадцати видит таймауты | Задача на следующий рабочий день; без ночных уведомлений; постмортем по желанию |
Правило PagerDuty стоит перенести дословно: «если сомневаетесь, считайте уровень более высоким» — понизить можно всегда, а потерянные 20 минут не вернуть. Уровень назначает командир в момент подтверждения, а не вся команда в чате. Региональная 404 из строки SEV2 — реальный сценарий из кейса о региональных 404 через CDN: из офиса сайт открывался, а робот и часть регионов получали ошибку.
Как организовать дежурства, чтобы не выгореть и не проспать SEV1
Дежурство держится на трёх настройках: недельная ротация с явной передачей смены, эскалация по времени и фильтр шума. Без третьей первые две не работают: дежурный, которого будили пять раз за неделю из-за 40-секундных таймаутов, на шестой выключит звук.
Google в главе Being On-Call называет пределы: не больше 25 % времени инженера на дежурстве, не больше двух значимых инцидентов за 12-часовую смену (на каждый с разбором уходит около 6 часов), реакция за 5 минут для пользовательских сервисов и 30 для менее чувствительных, минимум для круглосуточной ротации с основным и запасным — восемь человек. Втроём круглосуточную пятиминутную реакцию не удержать; реалистично — 5 минут днём и 30 ночью для SEV1, без ночных уведомлений для SEV2–SEV3.
Фильтр шума складывается из трёх механизмов мониторинга. Кворум: инцидент открывается, когда сбой видит заданная доля точек, а не одна, — отсекаются проблемы сети между конкретной точкой и сервером. Задержка уведомления: сообщение уходит, только если недоступность длится дольше заданного времени, — отсекаются микропадения при деплое. Гистерезис: порог закрытия отличается от порога открытия, чтобы «моргающий» сервис не порождал десять инцидентов вместо одного. В Пруфене это отдельные настройки проверки: порог по доле локаций с раздельными значениями для открытия и закрытия и задержка уведомления от 0 до 30 минут.
Эскалация по времени — одна таблица правил. Принцип из документации PagerDuty: первый в цепочке уведомляется немедленно, следующий — если предыдущий не подтвердил инцидент за таймаут; цепочку можно повторить ограниченное число раз, после чего инцидент остаётся на последнем ответственном. В псевдоконфиге для команды из трёх:
# escalation.yaml — псевдоконфиг, не синтаксис конкретного сервиса
schedule:
  rotation: weekly
  handoff: "Mon 10:00"          # передача смены голосом или в чате
  order: [anna, boris, viktor]  # primary / secondary / lead

alert_filter:
  check_interval: 2m            # обнаружение = интервал проверки
  open_quorum: 80%              # доля точек, увидевших сбой
  close_quorum: 100%            # закрыть, когда отвечает всем
  notify_delay: {sev1: 0m, sev2: 5m, sev3: 30m}

escalation:
  - {step: 1, notify: primary, wait: 10m}     # Telegram + Email
  - {step: 2, notify: [primary, secondary], wait: 15m}
  - {step: 3, notify: primary, channel: voice_call, wait: 15m}
  - {step: 4, notify: lead, repeat: 2}        # потом остаётся на lead
quiet_hours: {from: "00:00", to: "08:00", allow: [sev1]}
Порядок каналов важен: сначала бесшумные — мессенджер и почта, звонок — на третьем шаге, когда ресурс так и не поднялся; звонок на каждое 40-секундное падение перестают брать через неделю. Правило PagerDuty: «алерт — это то, что требует от человека действия», всё остальное — уведомление, которое не должно никого будить.
Как писать постмортем: blameless и шаблон на одну страницу
Постмортем, по определению SRE Book, — «письменная запись об инциденте, его влиянии, действиях по смягчению и устранению, корневых причинах и последующих задачах, предотвращающих повторение». Цель — не отчётность, а чтобы через месяц не разбирать тот же инцидент снова; у Atlassian это ценность «никогда не иметь один и тот же инцидент дважды».
Blameless — не про вежливость. SRE Book исходит из того, что «все участники инцидента имели добрые намерения и поступили правильно исходя из информации, которой располагали», а искать нужно «системные причины, по которым у человека или команды была неполная или неверная информация». Atlassian добавляет приём: называть людей по роли («дежурный инженер»), а не по имени. Причина прагматичная: как только постмортем становится поиском виноватого, детали скрывают, и корневая причина не находится. Обязателен он у Atlassian для Severity 1 и 2; SRE Book даёт триггеры: видимый пользователям простой, потеря данных, вмешательство дежурного (откат, переключение трафика), время устранения выше порога, сбой мониторинга.
Шаблон собран из примера в приложении SRE Book (Summary, Impact, Root Causes, Trigger, Resolution, Detection, Action Items, Lessons Learned, Timeline) и шаблона Atlassian (Leadup, Fault, Detection, Response, Recovery, Five Whys, Recurrence, Corrective actions), ужат до страницы:
# Постмортем INC-4: 5xx на оформлении заказа, 2026-09-23

**Статус:** черновик | на ревью | принят
**Авторы:** дежурный инженер (роль, не имя)
**Уровень:** SEV1   **Длительность:** 100 мин (11:30–13:10 МСК)

## Резюме (3 предложения)
Что сломалось, для кого, на сколько. Как починили.

## Влияние
Доля запросов с ошибкой, регионы, заказы, минуты из бюджета 43.

## Таймлайн (МСК; у каждой строки — источник)
| Время | Событие                                  | Источник   |
|-------|------------------------------------------|------------|
| 11:24 | Выкатка релиза 2.14.0                    | CI         |
| 11:30 | Первые 502 из точек мониторинга          | мониторинг |
| 11:32 | Инцидент открыт, уведомление в Telegram  | мониторинг |
| 11:33 | Дежурный подтвердил: «беру»              | чат        |
| 12:05 | Позван второй инженер                    | чат        |
| 12:40 | Откат до 2.13.2                          | CI         |
| 13:10 | Все точки отвечают 200, инцидент закрыт  | мониторинг |

## Корневая причина и триггер
Триггер: релиз 2.14.0. Причина: миграция открывала соединение к БД
на каждый запрос и не закрывала. Пять «почему»: 1. ... 2. ... 3. ...

## Обнаружение
Мониторинг, через 2 мин. Клиенты писали с 11:35 — опередили на 5 мин.

## Что сработало / что нет / где повезло
+ Кворум точек: инцидент открылся с первого запуска, без ложных
- Откат занял 35 мин: не было готовой команды, искали версию
~ Повезло: пиковый трафик начинается в 14:00

## Задачи (без владельца и срока строка не принимается)
| Задача                               | Тип      | Кто     | Срок  |
|--------------------------------------|----------|---------|-------|
| Скрипт отката одной командой         | mitigate | backend | 09-30 |
| Лимит и таймаут пула соединений      | prevent  | backend | 10-03 |
| «Эскалация через 15 мин» в регламент | process  | lead    | 09-26 |

## Повторяемость
Была ли такая причина раньше? Ссылки на прошлые постмортемы.
Три детали отличают рабочий постмортем от формального. Таймлайн собирается из источников с метками времени — история инцидентов мониторинга, CI, чат, — а не по памяти, которая сдвигает события на десятки минут. Столбец «Тип» взят из примера SRE Book: mitigate (быстрее чинить в следующий раз), prevent (не допустить повторения), process (изменить регламент); если все задачи — prevent, команда убеждает себя, что инцидент последний. Раздел «Где повезло» — самый честный: он показывает, какой инцидент случится следующим.
Как общаться с клиентами и нужна ли статус-страница
Первое сообщение клиентам выходит раньше, чем найдена причина: «Знаем о проблеме с оформлением заказа с 11:30, работаем, следующее обновление в 12:00». Клиент, который видит ошибку и молчание, пишет в поддержку и соцсети; клиент, который видит признание и время следующего апдейта, ждёт. Дальше — обновление каждые 20–30 минут, даже без новостей; после восстановления — с какого времени работает и что делать с зависшими заказами; через 1–5 дней — публичная версия постмортема без внутреннего таймлайна и имён. Не писать: гипотезы о причине, обещания сроков, «полностью решено» до постмортема.
Статус-страница нужна, когда клиентов больше, чем можно обзвонить, и она обязана жить на другой инфраструктуре: страница на том же сервере, что и сайт, падает вместе с ним; минимум — отдельный домен на стороннем хостинге или закреплённое сообщение в Telegram-канале. Что делать руками в первые минуты — в статье «Сайт упал: что делать»; здесь речь о процессе вокруг этого чеклиста.
Какие ошибки ломают инцидент-менеджмент в маленькой команде
Процесс ломают не сложные инциденты, а привычки, каждая из которых кажется экономией времени. Признак один: через три месяца метрики не улучшились, а инциденты повторяются.
| Ошибка | Как выглядит | К чему приводит | Как исправить |
|---|---|---|---|
| Постмортем как поиск виноватого | «Кто выкатил?», имена в таймлайне, вывод «быть внимательнее» | Детали скрывают, причина не найдена, инцидент повторяется | Роли вместо имён; вопрос «почему система позволила», а не «кто» |
| Задачи без владельца и срока | «Улучшить мониторинг», «подумать о резерве» | Через квартал не сделана ни одна, постмортемы перестают писать | Глагол в начале, один владелец, дата, задача в трекере |
| Метрики без определения | «MTTR 20 минут» без указания, от какого момента до какого | Цифры несравнимы между месяцами и с чужими | Формулы в регламенте; четыре метки времени на инцидент |
| Все уведомления одинаково громкие | Звонок на каждый таймаут одной точки, ночью — про диск на 80 % | Дежурный выключает звук, SEV1 приходит в тишину | Кворум, задержка уведомления, звонок только как эскалация |
Как внедрить инцидент-менеджмент за неделю
Семь шагов по дню на каждый; ничего сверх мониторинга и трекера задач, которые уже есть. Без первого шага не будет ни MTTD, ни таймлайна, ни постмортема.
- Поставьте внешний мониторинг на пять критичных URL — главную, каталог, карточку, корзину, оплату — с интервалом 2 минуты из нескольких точек. Сломайте тестовую страницу и засеките время до уведомления.
- Запишите на одну страницу: что считается инцидентом (три условия SRE Book под вашу команду), три уровня SEV с примерами из вашего сайта и четыре метки времени, фиксируемые в каждом инциденте.
- Настройте фильтр шума: кворум точек для открытия, отдельный порог для закрытия, задержку уведомления — 0 минут для оплаты и главной, 5 для остального. Цель — за неделю ни одного уведомления, на которое никто ничего не сделал.
- Составьте ротацию на месяц вперёд с передачей смены по понедельникам и цепочку эскалации: мессенджер дежурному → через 10 минут второму → звонок, если ресурс так и не поднялся → руководитель. Запишите тихие часы и какие уровни их пробивают.
- Заведите канал инцидентов с правилом «первое сообщение — «беру», последнее — «закрыто, постмортем до даты»» и журнал: id, четыре метки времени, уровень, ссылка на постмортем — источник для MTTD, MTTA и MTTR.
- Скопируйте шаблон постмортема в вики и напишите по нему разбор последнего инцидента, который команда помнит, — с таймлайном из логов и истории мониторинга, а не по памяти.
- Назначьте ежемесячный 30-минутный обзор: MTTD, MTTA, MTTR, число инцидентов по уровням, статус задач из постмортемов, одно изменение регламента. Задачи не закрываются два месяца подряд — инцидент процесса.
Пруфен проверяет сайт с интервалом от 2 минут из 20 точек мониторинга — 17 в России, а также Минск, Астана и Испания, — поэтому время обнаружения равно выбранному интервалу, а не времени до первой жалобы клиента. Инцидент открывается по кворуму точек; пороги открытия и закрытия настраиваются отдельно, задержка уведомления — от 0 до 30 минут, так что 40-секундное микропадение ночью никого не разбудит. Уведомления приходят на Email, в Telegram и Макс, а если ресурс так и не поднялся, подключается голосовой звонок. Для постмортема есть история инцидентов с временем открытия и закрытия, вкладка «По локациям» с результатами каждой точки и REST API с методами /incidents и /results — таймлайн собирается из них, а не по памяти. Бесплатный план — 5 проверок, при регистрации на счёт начисляется 150 ₽. Поставить критичные страницы на мониторинг.
Частые вопросы
Чем MTTR отличается от MTBF и что важнее для сайта? MTTR — среднее время от падения до восстановления, MTBF — среднее время работы между падениями; аптайм равен MTBF / (MTBF + MTTR). Для небольшой команды MTTR важнее: сократить его с часа до 15 минут можно за неделю (мониторинг, эскалация, скрипт отката), а поднять MTBF вчетверо — месяцы работы над архитектурой.
С какого момента считать начало инцидента, если мониторинг заметил его через 2 минуты, а клиент написал через 5? С момента, когда сервис фактически перестал работать, — по логам, а если не восстановить, то по первому неуспешному запуску мониторинга. Обнаружение — отдельная метка; разница между ними и есть время обнаружения. Если отсчитывать от уведомления, MTTD всегда будет нулём, и команда не увидит, что теряет до 20 % бюджета ошибок ещё до того, как о сбое кто-то узнал.
Нужен ли постмортем, если инцидент длился 8 минут и починился откатом? Да, если это SEV1 или SEV2, и да, если дежурному пришлось вмешаться руками: откат — один из триггеров в списке SRE Book. Такой постмортем — пять строк таймлайна и одна-две задачи, 20 минут работы. Короткие постмортемы приучают к практике; если писать их только на катастрофы, шаблон забудется к следующей.
Можно ли считать MTTR по данным мониторинга, а не по журналу, который заполняют люди? Начало и восстановление — да: история инцидентов мониторинга даёт открытие и закрытие с точностью до интервала проверки, это надёжнее ручных записей. Момент подтверждения дежурным (для MTTA) мониторинг не знает — его берут из чата или трекера. Схема: раз в месяц выгружать инциденты по API, добавлять время «беру» из канала и считать метрики скриптом вроде приведённого выше.