
 Артём Савельев
wget против curl: чем отличаются и что когда брать
Две утилиты делают, казалось бы, одно и то же — забирают что-то по HTTP. На деле они решают разные задачи, по-разному ведут себя при ошибках и в скриптах дают противоположные коды выхода на одном и том же 404. Разбираем различия по пунктам и собираем таблицу соответствия ключей.
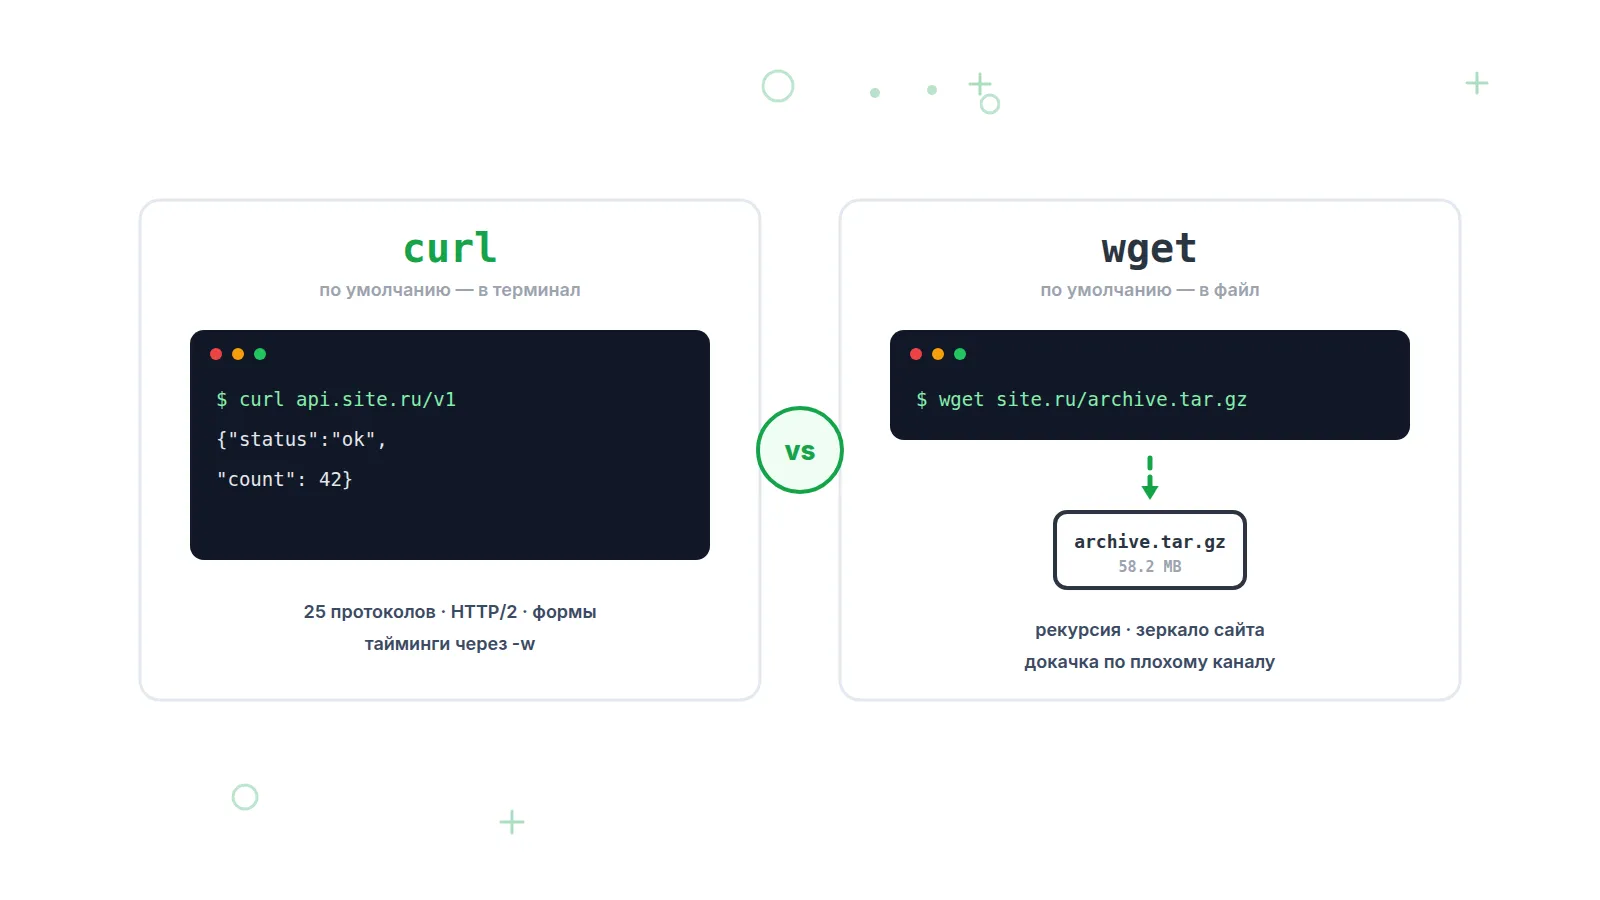
curl — универсальный клиент для передачи данных по двум десяткам протоколов, который по умолчанию печатает ответ в терминал; wget — загрузчик файлов, который по умолчанию сохраняет их на диск и умеет рекурсивно скачивать сайты целиком. Отсюда и разделение: curl — для запросов и диагностики, wget — для загрузки и зеркалирования.
Главные различия в одной таблице
| Критерий | curl 8.22 | wget 1.25 |
|---|---|---|
| Куда пишет по умолчанию | В stdout | В файл |
| Протоколов | 25 | 4 — HTTP, HTTPS, FTP, FTPS |
| Рекурсия и зеркалирование сайта | Нет, принципиально | Да — главный козырь |
| Следует редиректам по умолчанию | Нет, нужен -L | Да, до 20 шагов |
| HTTP/2 | Да, на HTTPS по умолчанию | Нет |
| HTTP/3 | Да, если сборка с QUIC | Нет |
| SOCKS-прокси | Да, 4, 4a, 5, 5h | Нет, только HTTP-прокси |
| Отправка форм multipart | Да, -F | Нет, только сырое тело |
| Параллельные загрузки | Да, -Z | Нет (есть в wget2) |
| Библиотека для встраивания | libcurl | Нет (libwget есть в wget2) |
| Соблюдает robots.txt | Нет | Да, при рекурсии |
Про версии: curl выходит примерно раз в восемь недель, последняя на момент написания — 8.22.0 от сентября 2026. У классического wget последний релиз 1.25.0 датирован ноябрём 2024 — ветка живёт в режиме поддержки. Преемник называется wget2 (версия 2.2.1), он умеет HTTP/2 и многопоточную загрузку, но drop-in-заменой не является: часть опций 1.x в нём не реализована.
Одни и те же задачи двумя командами
| Задача | curl | wget |
|---|---|---|
| Скачать в файл | curl -O URL |
wget URL |
| Задать имя файла | curl -o out.bin URL |
wget -O out.bin URL |
| Вывести в терминал | curl URL |
wget -qO- URL |
| Докачать | curl -C - -O URL |
wget -c URL |
| Следовать редиректам | curl -L URL |
по умолчанию |
| Свой заголовок | curl -H 'X-Token: abc' URL |
wget --header='X-Token: abc' URL |
| POST | curl -d 'a=1' URL |
wget --post-data='a=1' URL |
| Basic-авторизация | curl -u user:pass URL |
wget --user=u --password=p URL |
| Таймаут | --connect-timeout 5 --max-time 30 |
--timeout=30 |
| Повторы | --retry 3 --retry-delay 2 |
-t 3 --waitretry=2 |
| Ограничить скорость | --limit-rate 200k |
--limit-rate=200k |
| User-Agent | curl -A 'MyBot/1.0' URL |
wget -U 'MyBot/1.0' URL |
| Тихий режим | curl -sS URL |
wget -q URL |
| Только проверить наличие | curl -I URL |
wget --spider URL |
Одна деталь про тихий режим curl: голый -s глушит и прогресс, и сообщения об ошибках. В скриптах почти всегда нужен -sS — прогресса нет, ошибки видны.
Коды выхода: главная ловушка в скриптах
Это различие ломает больше всего скриптов. На ответе 404 или 500 wget вернёт код 8, а curl — код 0, потому что с его точки зрения передача прошла успешно: ответ получен. Чтобы curl реагировал на HTTP-ошибки, нужен ключ -f.
| Код curl | Что произошло |
|---|---|
| 0 | Успех |
| 6 | Не резолвится имя хоста — проблема в DNS |
| 7 | Не удалось подключиться — порт закрыт, хост недоступен |
| 22 | Код ответа 400 и выше. Появляется только с ключом -f |
| 28 | Таймаут |
| 35 | Провалился TLS-хендшейк — не сошлись версии или шифры |
| 52 | Сервер не ответил ничего |
| 56 | Обрыв при приёме данных |
| 60 | Сертификат не проверяется — нет цепочки до доверенного CA |
| Код wget | Что произошло |
|---|---|
| 0 | Всё в порядке |
| 1 | Общая ошибка |
| 2 | Ошибка разбора опций или .wgetrc |
| 3 | Ошибка ввода-вывода при записи файла |
| 4 | Сетевая ошибка |
| 5 | Не прошла проверка сертификата |
| 6 | Не приняты логин и пароль |
| 7 | Ошибка протокола |
| 8 | Сервер вернул ошибочный ответ — 4xx или 5xx |
Команда curl -s URL > file && process file на ответе 500 создаст файл со страницей ошибки и пойдёт дальше как ни в чём не бывало. Правильно — curl -fsS URL: с ключом -f тело ошибки не пишется, а код выхода становится 22. У wget такой проблемы нет: он и так вернёт 8.
Замер таймингов: то, что умеет только curl
У curl есть ключ -w, который печатает переменные по итогам запроса. Все времена кумулятивные, от старта передачи, в секундах.
| Переменная | До какого момента |
|---|---|
| time_namelookup | Имя разрезолвилось |
| time_connect | TCP-соединение установлено |
| time_appconnect | TLS-хендшейк завершён. Ноль для обычного HTTP |
| time_pretransfer | Всё готово, вот-вот пойдут данные |
| time_starttransfer | Получен первый байт — это и есть TTFB |
| time_total | Всё скачано |
Разности между соседними значениями и есть ответ на вопрос «где тормозит»:
| Этап | Как посчитать |
|---|---|
| DNS | time_namelookup |
| Сеть до сервера | time_connect − time_namelookup |
| TLS | time_appconnect − time_connect |
| Работа сервера | time_starttransfer − time_pretransfer |
| Скачивание тела | time_total − time_starttransfer |
curl -sS -L -o /dev/null \
  -w 'dns=%{time_namelookup} tcp=%{time_connect} tls=%{time_appconnect} ttfb=%{time_starttransfer} total=%{time_total} | code=%{http_code} ip=%{remote_ip} bytes=%{size_download}\n' \
  https://example.com

# Весь набор одним JSON-объектом
curl -sS -o /dev/null -w '%{json}' https://example.com | jq
Зеркалирование сайта: то, что умеет только wget
curl принципиально не умеет рекурсию — разработчики считают это задачей другого инструмента. У wget для этого есть целый набор ключей.
# Полное зеркало сайта для локального просмотра
wget --mirror --convert-links --adjust-extension \
     --page-requisites --no-parent https://example.com/

# Скачать только PDF из раздела, не уходя выше по дереву
wget -r -np -nd -A pdf https://example.com/docs/

# Вежливое зеркалирование: пауза между запросами
wget -r -l 3 --wait=1 --random-wait --limit-rate=500k https://example.com/
| Ключ | Что делает |
|---|---|
| --mirror | Сокращение для -r -N -l inf --no-remove-listing |
| --convert-links | Переписать ссылки, чтобы копия работала локально |
| --page-requisites | Забрать картинки, CSS и скрипты |
| --no-parent | Не подниматься выше стартового каталога |
| -l 3 | Глубина рекурсии |
| -A pdf, -R jpg | Брать только такие расширения или наоборот исключить |
| -e robots=off | Игнорировать robots.txt. Применять с пониманием последствий |
Почему --spider не заменяет нормальную проверку
Ключ --spider у wget проверяет, существует ли ресурс, не скачивая его. Звучит идеально для мониторинга, но у него четыре ограничения, о которых стоит знать до того, как построить на нём проверку.
| Ограничение | Последствие |
|---|---|
| Если сервер не поддерживает HEAD, wget падает обратно на GET | Тело всё равно качается, трафик тратится, счётчики на сервере срабатывают |
| Не выполняет JavaScript | Ссылки одностраничных приложений не проверяются |
| Соблюдает robots.txt | Часть битых ссылок молча пропускается |
| Возвращает только факт наличия | Ни кода ответа в явном виде, ни времени отклика |
Для проверки доступности честнее команда curl, которая печатает и код, и время:
curl -sS -o /dev/null -w '%{http_code} %{time_total}s\n' https://example.com
Что стоит по умолчанию в вашей системе
Скрипт, написанный на ноутбуке с macOS, может не завестись на сервере — и наоборот. Картина по системам такая.
| Система | curl | wget |
|---|---|---|
| Debian, обычная установка | Не всегда | Есть |
| Ubuntu Server | Есть | Есть |
| RHEL, Rocky, AlmaLinux | Есть, в BaseOS | Нет, ставить из AppStream |
| Alpine | Нет | Есть урезанный от busybox |
| macOS | Есть | Нет, только через Homebrew |
| Windows 10 и 11 | Есть, curl.exe в System32 | Нет вообще |
| Docker-образы debian, ubuntu, alpine | Нет | Только в alpine, от busybox |
В Windows PowerShell 5.1 имена curl и wget — это алиасы командлета Invoke-WebRequest, а не настоящие утилиты. Ключи вроде -O, -c, -r там не работают и выдают невнятные ошибки. Настоящий curl вызывается как curl.exe. Настоящего wget в Windows нет вообще. В PowerShell 7 этих алиасов уже нет, в cmd.exe их не было никогда.
Почему нельзя отключать проверку сертификата
Ключи -k у curl и --no-check-certificate у wget отключают не только проверку цепочки до доверенного центра, но и сверку имени хоста с сертификатом. Соединение остаётся зашифрованным, но подтверждения, что вы говорите с нужным сервером, больше нет — любой на пути может подставить свой сертификат и читать всё, включая пароли и токены.
Правильные решения вместо отключения: curl --cacert /path/ca.pem для своего центра сертификации, wget --ca-certificate= для того же у wget, обновление системного хранилища через update-ca-certificates. И отдельная частая причина: сбитые системные часы — при них валидный сертификат выглядит просроченным.
Что выбрать: короткий ответ
| Задача | Инструмент |
|---|---|
| Дёрнуть API, посмотреть заголовки, отладить запрос | curl |
| Померить, где именно тормозит ответ | curl |
| Загрузить файл на сервер, отправить форму | curl |
| Скачать большой файл с докачкой по плохому каналу | wget |
| Сохранить сайт или раздел целиком | wget |
| Забрать пачку файлов по списку в фоне | wget |
| Постоянно следить, что сайт отвечает | Ни то, ни другое |
Почему curl в cron — это не мониторинг
Схема «curl в кроне плюс отправка письма при ненулевом коде» выглядит бесплатной, пока не столкнёшься с тремя вещами. Проверка идёт из одной точки — если у вас проблема с маршрутом до конкретного региона, вы её не увидите. Сервер, с которого запускается cron, сам иногда падает, и тогда молчание означает не «всё хорошо», а «проверка не запускалась». И одиночный неудачный ответ неотличим от настоящего инцидента — нужен кворум по нескольким точкам.
Эти три вещи и составляют разницу между разовой командой и сервисом: проверка доступности делает тот же GET-запрос, но из разных локаций и сверяет код с ожидаемым, а HEAD-проверка — то же самое экономнее, без скачивания тела страницы.
Пруфен проверяет сайт с интервалом от 2 минут из 13 точек мониторинга, подтверждает инцидент кворумом по локациям и присылает уведомление в Email, Telegram или Макс, а на затяжную недоступность — голосовым звонком. Бесплатный план — 5 проверок, плюс 150 ₽ на баланс при регистрации.